 DUKE
Có một câu mà tôi nghe đi nghe lại suốt nhiều năm làm nghề, ở mọi công ty, mọi team, mọi quy mô hệ thống. Câu đó là:
"Anh ơi, hệ thống chậm."
Và ngay sau đó, gần như theo phản xạ, sẽ có một ai đó nói:
"Chắc do query. Tối ưu SQL đi."
Tôi không đếm nổi bao nhiêu lần chứng kiến cảnh này. Một bạn developer mở laptop, tìm câu query dài nhất trong codebase, thêm vài cái index, rewrite lại join, deploy lên... và hệ thống vẫn chậm. Bởi vì vấn đề chưa bao giờ nằm ở query cả. Lần thì nó nằm ở connection pool bị cạn. Lần thì ở một service downstream đang retry điên cuồng. Lần thì ở GC pause. Có lần, vấn đề nằm ở... DNS.
Hôm nay ngồi cà phê, tôi muốn tản mạn một chút về thứ đứng đằng sau tất cả những câu chuyện đó: Observability.
Nhưng khoan. Nếu bạn đang chờ một bài hướng dẫn cài Prometheus, dựng Grafana dashboard, hay tích hợp OpenTelemetry, thì bạn có thể đóng tab này lại. Bài viết này không nói về công cụ. Bài viết này nói về một thứ quan trọng hơn nhiều: cách đặt câu hỏi khi hệ thống có vấn đề.
Vì theo kinh nghiệm của tôi, Observability dịch ra Tiếng Việt là "khả năng quan sát", nó không phải là một bộ công cụ, nó là một phương pháp điều tra. Trong ngữ cảnh này có 1 từ tôi nghĩ nó thích hợp để diễn tả: "tầm nhìn".
Hệ thống là một thành phố
Để dễ hình dung, tôi muốn rủ bạn cùng tưởng tượng một thứ.
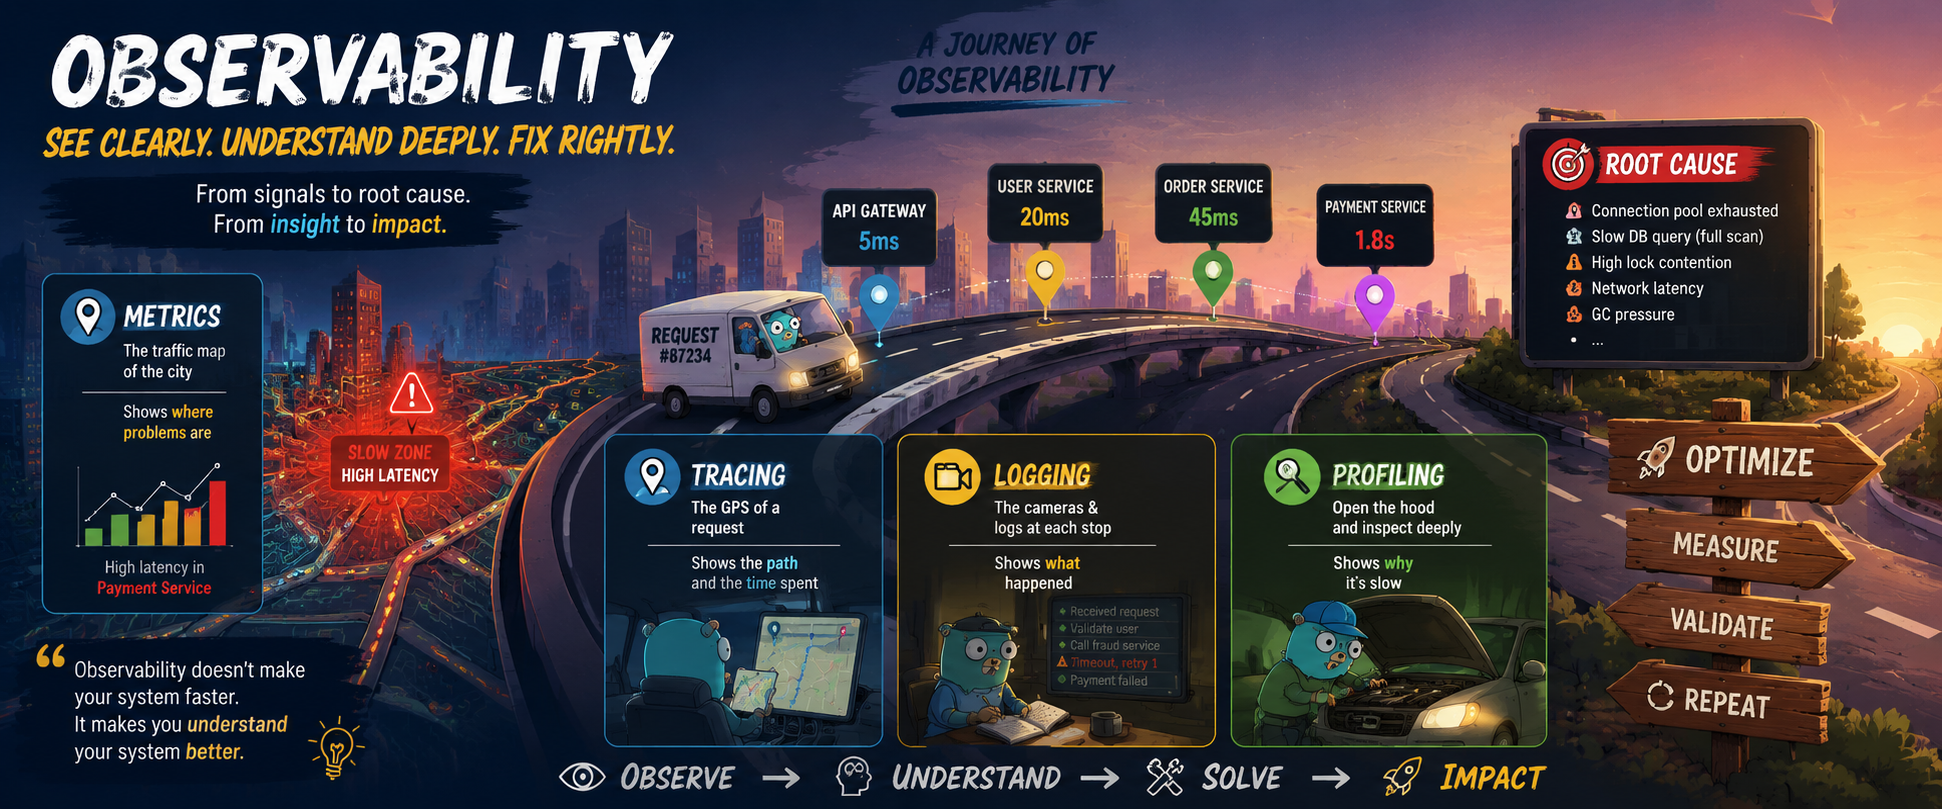
Hãy hình dung hệ thống của bạn là một thành phố. Một thành phố thật sự, với những con đường lớn nhỏ, những giao lộ, những khu công nghiệp, những kho hàng, những trạm thu phí.
API gateway là cổng chào của thành phố. Các service là những khu phố, mỗi khu một nghề. Database là khu kho bãi trung tâm, nơi mọi hàng hóa được cất giữ. Message queue là bãi đỗ xe chờ. Cache là mấy cái kho tạm đặt rải rác gần khu dân cư, để đỡ phải chạy về kho trung tâm.
Còn mỗi request của người dùng? Đó là một chiếc xe giao hàng.
Người dùng bấm nút "Đặt hàng", một chiếc xe xuất phát từ cổng thành phố, chạy qua khu xác thực để trình giấy tờ, ghé khu kiểm tra tồn kho, vòng về kho trung tâm lấy hàng, tạt qua trạm thanh toán, rồi quay lại cổng để trả kết quả. Toàn bộ chuyến đi đó, với chúng ta, chỉ là một con số: response time.
Khi người dùng than "app chậm quá", thực chất họ đang nói: chiếc xe giao hàng của tôi về trễ.
Và câu hỏi của người kỹ sư không phải là "tối ưu cái gì", mà là:
Chiếc xe đó đã bị kẹt ở đâu, và vì sao?
Đây chính là lúc câu chuyện Observability bắt đầu. Bởi vì để trả lời câu hỏi đó, bạn cần nhìn thành phố của mình theo nhiều lớp khác nhau. Và mỗi lớp, thú vị thay, lại tương ứng với một "trụ cột" mà người ta hay nhắc: Metrics, Tracing, Logging, Profiling.
Nhưng thay vì định nghĩa chúng theo kiểu sách giáo khoa, tôi muốn kể cho bạn nghe chúng là gì trong thành phố của chúng ta.
Metrics — tấm bản đồ giao thông của cả thành phố
Bạn đã bao giờ mở Google Maps vào giờ tan tầm chưa? Cả thành phố hiện ra trước mắt, với những vệt xanh, vàng, đỏ. Đường nào thông thoáng, đường nào ùn ứ, khu nào đang tê liệt — nhìn một cái là biết.
Metrics chính là tấm bản đồ đó.
Nó cho bạn biết: khu thanh toán đang đỏ rực, latency p99 tăng gấp ba từ 2 giờ chiều. Khu tìm kiếm vẫn xanh, bình thường. Lượng xe đổ vào cổng thành phố tăng 40% so với hôm qua. Kho trung tâm đang xử lý chậm hơn mọi khi.
Đó là thứ Metrics giỏi nhất: cho bạn biết khu vực nào có vấn đề, và có vấn đề từ khi nào.
Nhưng có một điều tấm bản đồ này không bao giờ nói được. Nó không cho bạn biết chiếc xe nào đang bị kẹt. Nhìn vệt đỏ trên bản đồ, bạn không thể biết chiếc xe giao đơn hàng #4817 của chị khách VIP đang nằm ở đâu trong đám tắc đó, hay vì sao nó lại lạc vào đúng con đường ấy.
Metrics trả lời câu hỏi "ở đâu đang có chuyện?" — nhưng nó im lặng trước câu hỏi "chuyện gì đang xảy ra với chuyến hàng cụ thể này?".
Nhiều bạn developer dừng lại ở đây. Thấy dashboard đỏ ở database, thế là kết luận "database chậm, tối ưu query thôi". Đó giống như thấy đường đỏ trên bản đồ rồi kết luận "chắc tại đèn giao thông", trong khi thực ra phía trước có một chiếc xe container quay đầu giữa đường.
Bản đồ chỉ cho ta biết nên nhìn vào đâu. Nó chưa bao giờ là câu trả lời.
Tracing — chiếc GPS gắn trên từng chiếc xe
Bây giờ, hãy gắn một thiết bị GPS lên chiếc xe giao đơn hàng #4817.
Cuối ngày, bạn mở dữ liệu GPS ra xem, và mọi thứ hiện lên rõ mồn một: xe xuất phát lúc 14:02:15. Qua trạm xác thực mất 3 giây — hơi lâu, bình thường chỉ mất nửa giây. Chạy đến khu kiểm tra tồn kho, mất 200ms, ổn. Rồi đến kho trung tâm... và đứng yên ở đó 8 giây. Sau đó mọi chặng còn lại đều nhanh.
Đó là Tracing.
Tracing kể lại hành trình của một chuyến đi cụ thể: xe đi qua những đâu, dừng ở đâu, mất bao lâu trên từng chặng. Trong thế giới microservices, nơi một request có thể chạy qua chục service khác nhau, tracing là thứ duy nhất cho bạn thấy bức tranh xuyên suốt của một chuyến hàng.
Và đây là điểm tôi muốn bạn để ý, vì rất nhiều người hiểu sai chỗ này:
Tracing chỉ giúp khoanh vùng. Nó không giải thích nguyên nhân.
GPS nói với bạn: "xe đứng yên trước cổng kho trung tâm 8 giây". Chấm hết. Nó không nói vì sao. Xe chờ vì cổng kho quá tải? Vì bảo vệ kiểm tra giấy tờ lâu? Vì trong kho có hai xe nâng đang tranh nhau một lối đi? Vì tài xế... ngủ gật?
GPS không biết. GPS chỉ biết tọa độ và thời gian.
Tôi từng thấy nhiều team dừng cuộc điều tra ở đây: mở trace ra, thấy span của database dài nhất, và lập tức kết luận "database chậm". Rồi họ lao vào tối ưu query — quay lại đúng cái phản xạ ở đầu bài. Nhưng "thời gian nằm ở database" và "database chậm" là hai chuyện rất khác nhau. Có thể query chạy 5ms, nhưng connection phải chờ 7.995ms mới được cấp từ pool. Trace nhìn bề ngoài giống hệt nhau. Nguyên nhân thì một trời một vực.
Khoanh vùng xong, cuộc điều tra mới đi được nửa đường.
Logging — camera giao thông và sổ nhật ký ở từng trạm
Quay lại chiếc xe #4817 đứng trước kho 8 giây. Muốn biết chuyện gì xảy ra ở đó, bạn làm gì? Bạn xem lại camera ở cổng kho, và lật sổ nhật ký của trạm bảo vệ.
Và trong sổ, bạn đọc được những dòng thế này:
14:02:19  Xe #4817 đến cổng, xếp hàng sau 12 xe khác
14:02:21  Xe #4817 trình giấy, thiếu chữ ký, yêu cầu bổ sung
14:02:24  Xe #4817 gọi về tổng đài xin xác nhận — lần 1 thất bại
14:02:26  Xe #4817 gọi về tổng đài xin xác nhận — lần 2 thành công
14:02:27  Xe #4817 được phép vào kho
À ra thế. Chuyện không phải kho chậm. Chuyện là giấy tờ thiếu chữ ký và phải retry hai lần khi gọi tổng đài.
Đó là Logging: lời kể của từng trạm về những gì đã xảy ra. Xe bị trả hàng. Xe phải quay đầu. Xe chờ xác nhận. Xe thử lại ba lần rồi mới đi tiếp. Những sự kiện, những quyết định, những cú rẽ bất thường — thứ mà cả bản đồ lẫn GPS đều không ghi lại được.
Nếu Metrics trả lời "ở đâu?", Tracing trả lời "chặng nào?", thì Logging trả lời: "điều gì đã xảy ra?"
Nhưng logging cũng có cái bẫy của nó. Một thành phố gắn camera ở mọi góc phố và bắt mọi trạm ghi chép mọi thứ sẽ tạo ra một núi băng ghi hình không ai xem nổi. Log mà không có ngữ cảnh — không biết thuộc chuyến xe nào, không biết nằm ở chặng nào — thì chỉ là tiếng ồn. Đó là lý do người có kinh nghiệm luôn gắn log với trace, như thể ghi số hiệu chuyến xe vào từng dòng nhật ký. Để khi cần, họ lần ngược lại được cả câu chuyện của đúng một chuyến hàng, thay vì bơi trong hàng triệu dòng chữ của cả thành phố.
Vậy là ta đã biết chuyện gì xảy ra. Nhưng vẫn còn một câu hỏi cuối cùng, câu khó nhất: tại sao?
Tại sao cuộc gọi về tổng đài lại thất bại? Tại sao trạm xác thực hôm nay xử lý mất 3 giây thay vì nửa giây? Muốn trả lời, bạn phải làm một việc mà bản đồ, GPS hay camera đều không làm được.
Bạn phải mở nắp capo.
Profiling — mở nắp capo, mổ xẻ từng đoạn đường
Đây là phần tôi muốn dành nhiều thời gian nhất, vì nó là phần bị hiểu hẹp nhất.
Nói đến profiling, đa số lập trình viên nghĩ ngay đến pprof, đến flame graph, đến CPU profiling. Đúng, nhưng chưa đủ. Hãy nghĩ rộng hơn.
Chiếc xe #4817 chạy chậm trên một đoạn đường. GPS đã khoanh vùng được đoạn đó. Camera đã cho biết xe không gặp sự cố giấy tờ gì. Vậy mà xe vẫn ì ạch. Lúc này, người thợ giỏi sẽ làm gì?
Mở nắp capo xe ra xem. Động cơ có nóng không? Dầu nhớt thế nào? Có bánh nào non hơi không?
Và nếu xe không sao, thì mổ xẻ chính đoạn đường đó: mặt đường có ổ gà không? Có công trình đang thi công chiếm nửa lòng đường không? Đèn tín hiệu ở giao lộ có bị lệch pha không?
Profiling, theo nghĩa rộng nhất, là deep inspection — soi sâu vào bên trong từng thành phần để tìm nguyên nhân vật lý thật sự của sự chậm chạp. Và mỗi thành phần trong hệ thống đều có "nắp capo" riêng của nó:
Trong application, đó là CPU profiling (động cơ đang đốt sức vào việc gì?), memory profiling (xe có chở lố tải, có rò rỉ xăng không?), mutex profiling (các bộ phận có đang tranh nhau một tài nguyên không?), goroutine hay thread profiling (có bao nhiêu tài xế đang chờ việc, bao nhiêu đang kẹt?).
Trong database, nắp capo chính là query planner: EXPLAIN ANALYZE, execution plan. Nó cho bạn thấy con đường mà database thật sự đi để lấy dữ liệu — quét cả bảng hay nhảy theo index, join theo kiểu nào, sort ở đâu, đọc bao nhiêu trang từ disk. Nhiều người tưởng mình biết query chạy thế nào; execution plan tồn tại để chứng minh điều ngược lại.
Trong connection pool, đó là pool statistics: bao nhiêu connection đang bận, bao nhiêu xe đang xếp hàng chờ được cấp connection, thời gian chờ trung bình là bao nhiêu. Đây là thủ phạm bị bỏ sót nhiều nhất mà tôi từng gặp — vì nó đứng ngay giữa application và database, và cả hai bên đều... trông vô tội.
Trong storage, đó là disk IO: iostat, độ trễ đọc ghi, queue depth. Cái kho có thể bố trí hợp lý, nhưng nếu cái kệ (ổ đĩa) rút hàng chậm thì mọi thứ phía trên đều chậm theo.
Trong network, đó là RTT, packet loss, retransmission. Đôi khi đường sá không hẹp, chỉ là mặt đường xấu khiến xe nào chạy qua cũng phải giảm tốc — và không một dòng code nào của bạn có lỗi cả.
Bạn thấy điểm chung không? Tracing chỉ nói được đoạn đường nào chậm. Profiling mới trả lời được vì sao đoạn đường đó chậm.
Đây là hai tầng câu hỏi hoàn toàn khác nhau, và cũng là ranh giới giữa hai kiểu kỹ sư: người dừng ở "database span dài quá" và người đào tiếp đến "à, plan bị lệch vì statistics cũ, nên planner chọn nested loop thay vì hash join trên một bảng 10 triệu dòng".
Câu chuyện thật mà tôi nhớ mãi: một hệ thống của chúng tôi cứ đến giờ cao điểm là API chậm. Metrics chỉ vào database. Trace cũng chỉ vào database. Cả team đã sẵn sàng ngồi rewrite query. Nhưng khi mở pool statistics ra thì hóa ra query chỉ chạy vài millisecond — thứ chiếm thời gian là chờ được cấp connection, vì một background job chiếm dụng gần hết pool mỗi 15 phút. Nguyên nhân gốc rễ chẳng liên quan gì đến SQL. Sửa một dòng config, chia lại pool, xong.
Nếu hôm đó chúng tôi "tối ưu SQL theo cảm giác", chúng tôi đã tốn hai tuần để không sửa được gì.
Giành giựt từng millisecond, trong khi từng giây rơi ngoài kia
Nói đến đây, tôi phải thú nhận một điều. Profiling application rất... gây nghiện.
Mở flame graph lên, thấy một hàm chiếm 12% CPU, tối ưu nó xuống còn 4%, đo lại thấy latency giảm được 3 millisecond — cảm giác đó rất đã. Nó cho ta cái khoái cảm của người thợ kim hoàn: từng đường dũa, từng con số, đo được, thấy được, khoe được. Tôi đã từng có thời nghiện đúng thứ đó, ngồi cả tuần để gọt một hot path.
Cho đến khi tôi ngộ ra một chuyện: trong một hệ thống phân tán, mình đang giành giựt từng millisecond trong nhà, trong khi từng giây, từng phút đang rơi ngoài đường.
Quay lại thành phố của chúng ta mà xem. Chiếc xe giao hàng mất 4 giây cho một chuyến đi. Trong 4 giây đó: 1 giây kẹt ở giao lộ vì biển báo sai khiến xe rẽ nhầm rồi vòng lại — một cái timeout config sai, một service discovery trả về node chết; 1.5 giây bò qua đoạn đường đầy ổ gà — network chập chờn, retransmission liên tục; 800ms xếp hàng trước trạm thu phí — connection pool cạn, queue dồn ứ. Còn cái động cơ của xe — application code của bạn — đóng góp đâu đó... 40 millisecond.
Và chúng ta làm gì? Chúng ta lôi xe ra sửa trước. Dù chiếc xe, nói thật lòng, vẫn đang chạy tàm tạm.
Khoan đã. Trước khi tháo động cơ, hãy tự hỏi một câu — câu này tôi muốn bạn dán lên màn hình:
Bạn đã chắc chắn đường xá ngon lành chưa? Biển báo đã chỉ đúng hướng chưa? Trạm thu phí đã thông thoáng chưa — mà đã lôi xe ra độ?
Chưa kiểm tra đường mà đã độ xe — thay turbo, nâng máy, gắn lốp xịn — thì độ đến đâu, chiếc xe vẫn kẹt ở đúng giao lộ cũ. Một chiếc F1 vẫn phải đứng im trước đèn đỏ. Bạn không mua được tốc độ khi thứ giam chiếc xe lại không nằm trong chiếc xe.
Liên tưởng sang lập trình viên thì hình ảnh này quen đến mức... đau lòng. Chưa mở metrics, chưa lần theo nổi một cái trace, chưa đọc một dòng log — nhưng đã hăng hái rewrite service, thay JSON bằng protobuf, rải cache khắp nơi, đẩy mọi thứ vào goroutine, thậm chí đòi đổi cả ngôn ngữ "cho nó nhanh". Nghe thì rất máu lửa. Nhưng đó không phải tối ưu. Đó là độ xe khi chưa hề mở bản đồ. Và cái giá không chỉ là vô ích: mỗi lần "độ" là một lần hệ thống phức tạp thêm, khó đọc thêm, thêm chỗ để hỏng — trong khi cái giao lộ gây kẹt vẫn nằm nguyên ở đó, đợi chiếc xe vừa được nâng cấp quay lại xếp hàng.
Vì sao? Một phần, đúng, vì cái xe là của mình, còn đường sá là chuyện "hạ tầng", chuyện "team khác". Nhưng đó chưa phải lý do sâu nhất. Lý do sâu nhất là: phần lớn developer không biết những thứ đó tồn tại.
Để ý mà xem. Chúng ta được đào tạo rất kỹ về động cơ. Học ngôn ngữ, học framework, học thuật toán, thuộc từng tùy chọn của GC, đọc vanh vách chuyện slice trong Go cấp phát bộ nhớ ra sao. Chuyên môn về application của chúng ta rất sâu. Nhưng connection pool hoạt động thế nào, keep-alive là gì, một cú TLS handshake tốn bao nhiêu round-trip, serialize một payload 5MB tốn kém ra sao, timeout và retry phối hợp với nhau kiểu gì để tạo thành retry storm — những thứ đó không nằm trong giáo trình nào, không tutorial nào dạy, và không hiện ra trong IDE. Chúng chỉ lộ diện khi hệ thống đủ lớn và đủ đau.
Mà con người thì không thể nghi ngờ một thứ mình không biết nó tồn tại. Trên tấm bản đồ trong đầu của một developer chỉ quen với application, những vùng đó là vùng trắng — không phải vùng "ngại đến", mà là vùng chưa từng được vẽ. Nên khi hệ thống chậm, ánh mắt tự động quét về nơi duy nhất có trên bản đồ: code của mình. Flame graph không phải là công cụ tốt nhất cho vấn đề — nó chỉ là công cụ duy nhất mà ta biết cầm.
Trong khi đó, nói thật, chỉ riêng việc hiểu connection pool hoạt động thế nào thôi đã đủ giải quyết một phần lớn các vấn đề performance mà tôi từng gặp trong đời. Pool size bao nhiêu là đủ, chuyện gì xảy ra khi pool cạn, vì sao "query nhanh mà response chậm". Một khái niệm, vài giờ tìm hiểu — đổi lại nhiều năm bớt đoán mò. So với công sức gọt 5ms trong app bằng flame graph, trong khi một cơn retry storm ngoài kia đang đổ thêm 3 giây vào mỗi request, thì khoản đầu tư nào lời hơn, bạn tự trả lời được rồi đấy.
Muối bỏ bể. Đúng nghĩa đen.
Vậy khi nào mở nắp capo application mới là lựa chọn đúng? Có hai trường hợp. Một, khi cuộc điều tra đã loại trừ hết đường sá — metrics, tracing, logging đều chỉ về phía chiếc xe, và bạn chắc chắn đây là chặng cuối. Hai, khi bạn nghi ngờ có leak — memory leak, goroutine leak, connection leak. Leak là ngoại lệ đặc biệt: nó không làm bạn mất vài millisecond, nó âm thầm tích tụ như một vết nứt trong khung gầm, cho đến ngày cả chiếc xe nằm đường. Với leak, mở nắp capo không phải là quá sớm — mà thường là đã quá muộn.
Nếu bạn rơi vào một trong hai trường hợp đó, tôi có viết riêng một bài về chuyện khám bệnh cho ứng dụng: Profiling: Khám bệnh Golang application. Còn nếu chưa — hãy quay lại tấm bản đồ.
Một thành phố quy hoạch tốt thì ít phải điều tra
Còn một tầng nữa của câu chuyện này, ít người nói ra nhưng tôi thấy quan trọng nhất.
Một ứng dụng có kiến trúc tốt giống một thành phố quy hoạch tốt: ai nhìn vào cũng biết nó tốt, và khi một chi tiết hỏng, ai cũng biết ngay chi tiết nào. Đường nào ra đường đó, khu nào ra khu đó, ranh giới rõ ràng, luồng đi dễ đoán. Ở một hệ thống như vậy, phần lớn chi phí điều tra... biến mất. Anh em chỉ cần liếc metrics là khoanh vùng được, vì cấu trúc của hệ thống tự nó đã là một tấm bản đồ dễ đọc. Observability tốt nhất, hóa ra, bắt đầu từ kiến trúc dễ hiểu — chứ không phải từ việc gắn thêm camera.
Chiều ngược lại mới đáng sợ. Khi bạn làm xấu một góc hệ thống — hoặc thấy nó xấu mà để yên — thì có ba chuyện sẽ xảy ra, và chuyện nào cũng leo thang. Thứ nhất, chính bạn sẽ không muốn quay lại sửa, vì càng để lâu càng ngại. Thứ hai, bạn mất luôn tư cách yêu cầu người khác sửa phần của họ — code review của bạn từ đó nhẹ tay hẳn, vì ai cũng biết cái góc kia là của ai. Thứ ba, và tệ nhất: cái xấu đầu tiên trở thành tiền lệ cho những cái xấu sau. Một khung cửa sổ vỡ không ai thay, thì chẳng bao lâu cả dãy phố vỡ theo. Người mới vào team nhìn quanh, thấy "ở đây người ta làm vậy", và làm theo. Sự xuống cấp của một hệ thống hiếm khi đến từ một quyết định lớn — nó đến từ một chuỗi những lần "thôi kệ".
Nói vậy không có nghĩa là mọi thứ phải hoàn hảo. Thành phố nào cũng có ổ gà chưa kịp vá — quý này không có ngân sách, sprint này không còn ai rảnh. Nợ kỹ thuật là được phép. Nó là một công cụ tài chính hẳn hoi: vay tốc độ hôm nay, trả bằng công sức ngày mai. Nhưng có hai kiểu nợ rất khác nhau. Ổ gà có rào chắn và biển cảnh báo — một comment // TODO tử tế, một ticket trong backlog, một dòng trong ADR ghi rõ "chỗ này tạm, vì lý do X, trả trước ngày Y" — đó là nợ trả được. Còn ổ gà bị lấp vội bằng một tấm ván mỏng rồi... quên — đó không còn là nợ nữa. Nó lặng lẽ trở thành địa hình. Vài năm sau, người ta xây hẳn một con đường mới vòng qua nó, và không ai còn nhớ vì sao con đường lại cong.
Cho nên nếu phải để một chỗ xấu, hãy để nó xấu một cách có hồ sơ. Nợ được ghi sổ là nợ trả được. Nợ không ghi sổ, sớm muộn cũng thành một phần của thành phố.
Cảm giác của bạn khả năng cao là sai, hãy bắt tay vào điều tra
Đến đây, có lẽ bạn đã thấy được cái mạch mà tôi muốn vẽ ra. Mỗi lớp quan sát trả lời một câu hỏi, và các câu hỏi nối tiếp nhau như một cuộc điều tra:
Metrics    →  Khu vực nào của thành phố đang có vấn đề?
Tracing    →  Chuyến xe cụ thể bị chậm ở chặng nào?
Logging    →  Ở chặng đó, điều gì đã xảy ra?
Profiling  →  Vì sao nó xảy ra? Bên trong bị gì?
    ↓
Root Cause →  Nguyên nhân gốc rễ
    ↓
Optimization →  Bây giờ mới tối ưu
Để ý một điều: tối ưu là bước cuối cùng. Nó là phần thưởng cho một cuộc điều tra tử tế, không phải là điểm xuất phát.
Trong khi đó, cái phản xạ phổ biến ngoài kia lại là một đường tắt chết người:
"Hệ thống chậm" → "Tối ưu SQL"Nhảy thẳng từ triệu chứng đến giải pháp, bỏ qua toàn bộ khâu điều tra. Nó giống như bác sĩ nghe bệnh nhân nói "em đau bụng" rồi lập tức... mổ ruột thừa. Đôi khi trúng. Nhưng trúng nhờ may mắn, không phải nhờ hiểu biết. Và trong nghề này, thứ nguy hiểm nhất chính là những lần may mắn — vì nó dạy cho ta thói quen đoán mò, cho đến ngày cái giá phải trả đủ lớn.
Người ta hay nghĩ khác biệt giữa Junior và Senior nằm ở việc Senior biết nhiều công nghệ hơn, gõ code nhanh hơn. Theo tôi thì không hẳn. Khác biệt lớn nhất là: khi hệ thống có vấn đề, Junior đề xuất giải pháp, còn Senior đề xuất câu hỏi.
Junior nói: "Chắc do query, để em thêm index." Senior hỏi: "Chậm từ khi nào? Chậm ở endpoint nào? Tất cả request chậm hay chỉ một nhóm? p50 tăng hay chỉ p99 tăng? Có deploy gì gần đây không?"
Nghe thì có vẻ Senior chậm chạp hơn. Nhưng người đi chậm ở khúc đầu lại thường về đích trước, vì họ không phải quay đầu giữa chừng.
Hai câu hỏi phỏng vấn nghe giống nhau mà khác nhau một trời
Giờ tôi kể bạn nghe một chuyện mà tôi nghiệm ra sau nhiều năm ngồi cả hai phía của bàn phỏng vấn.
Có hai câu hỏi nghe na ná nhau:
"Em làm gì để tối ưu query?"
và
"Em làm gì để tối ưu performance?"
Thoạt nghe như một. Nhưng với tôi, đây là hai câu hỏi hoàn toàn khác nhau, và cách ứng viên trả lời cho tôi biết rất nhiều về đẳng cấp của họ.
"Tối ưu query" là câu chuyện bên trong một thành phần duy nhất: database. Thêm index, đọc execution plan, rewrite query, tránh N+1, phân vùng bảng. Đó là kỹ năng tốt, cần thiết, và có thể học khá nhanh. Nó giống như kỹ năng của một người thợ máy giỏi về động cơ: đưa cái động cơ đây, tôi chỉnh cho nó bốc hơn.
"Tối ưu performance" là một câu chuyện khác hẳn. Nó là câu chuyện của cả thành phố. Bởi vì khi chiếc xe giao hàng về trễ, nguyên nhân có thể nằm ở bất cứ đâu: application đang serialize một payload khổng lồ; cache miss hàng loạt vì key hết hạn cùng lúc; network giữa hai service có packet loss; connection pool cạn; hai luồng xử lý đang giành nhau một cái lock; GC dừng cả thế giới vài trăm millisecond; một downstream service chậm và kéo mọi thứ chậm theo; queue bị dồn ứ; disk bận; và — vâng — cũng có thể là database.
Database chỉ là một mắt xích trong chuỗi đó. Một mắt xích quan trọng, nhưng vẫn chỉ là một.
Cho nên mới có chuyện này, nghe hơi ngược đời nhưng ngẫm lại rất tự nhiên:
Một người chỉ biết tối ưu query chưa chắc biết tối ưu performance. Nhưng một người biết tối ưu performance thì chắc chắn phải biết điều tra trước khi kết luận.
Vì bạn không thể tối ưu cả một thành phố bằng cách chỉ giỏi sửa động cơ. Bạn phải biết đọc bản đồ, biết lần theo GPS, biết lật sổ nhật ký, biết lúc nào cần mở nắp capo — và mở nắp capo của đúng chiếc xe, đúng đoạn đường.
Ứng viên trả lời câu "tối ưu performance" mà mở đầu bằng "đầu tiên em sẽ xem metrics để khoanh vùng..." — tôi biết mình đang nói chuyện với một người từng thật sự vật lộn với production. Còn ứng viên mở đầu bằng "em sẽ thêm index" — tôi biết bạn ấy đang trả lời một câu hỏi khác, câu hỏi mà bạn ấy ước là tôi đã hỏi.
Sự khác biệt đó, gọi tên ra, chính là khác biệt giữa sửa triệu chứng và tìm nguyên nhân gốc rễ. Sửa triệu chứng thì hệ thống êm được một thời gian, rồi vấn đề quay lại dưới một bộ mặt khác. Tìm được nguyên nhân gốc rễ thì vấn đề đó biến mất — và quan trọng hơn, bạn hiểu hệ thống của mình thêm một tầng.
Vài dòng suy ngẫm thay lời kết
Ly cà phê cũng sắp cạn rồi, tôi muốn khép lại bằng một ý nghĩ mà càng làm lâu tôi càng thấm.
Observability không khiến hệ thống của bạn chạy nhanh hơn. Cài thêm mười cái dashboard, hệ thống vẫn chậm y như cũ. Thứ Observability mang lại là một điều khác: nó khiến chúng ta hiểu hệ thống hơn. Và sự hiểu đó mới là nền móng của mọi lần tối ưu tử tế.
Tôi từng nghĩ một lập trình viên giỏi là người biết nhiều công cụ. Giờ tôi nghĩ khác. Công cụ đến rồi đi — mười năm trước chúng ta nói về Nagios, giờ nói về OpenTelemetry, mười năm nữa sẽ là một cái tên khác. Nhưng cách đặt câu hỏi thì ở lại. Một lập trình viên giỏi không phải là người biết nhiều công cụ. Mà là người biết đặt đúng câu hỏi. "Chậm ở đâu?" trước "chậm ở chặng nào?", trước "chuyện gì đã xảy ra?", trước "vì sao?". Đúng thứ tự, không nhảy cóc, không đoán mò.
Và nếu phải tóm cả bài tản mạn dài dòng này vào hai câu, thì tôi sẽ chọn hai câu này:
Performance không bắt đầu bằng tối ưu. Performance bắt đầu bằng quan sát.
Lần tới, khi ai đó chạy đến bàn bạn và nói "anh ơi, hệ thống chậm", đừng vội mở file SQL. Hãy mở tấm bản đồ thành phố ra trước đã.
Chiếc xe giao hàng đang kẹt ở đâu đó ngoài kia. Và việc của chúng ta không phải là đoán — mà là đi tìm nó.
Đó, với tôi, mới là ý nghĩa thật sự của Observability.
Bình luận