 DUKE
Goroutine và channel là nguyên liệu thô; các pattern concurrency là công thức mà lập trình viên Go giàu kinh nghiệm dùng đi dùng lại. Trong bài này, chúng ta sẽ đi qua bảy pattern — generator, fan-in, fan-out, pipeline, worker pool, queuing và semaphore — rồi tìm hiểu cách biến mỗi pattern thành phiên bản có thể hủy (cancelable) và sẵn sàng cho production.
Đây là bản đồ nhanh để biết khi nào dùng pattern nào: dùng generator khi cần tạo một lazy stream of values theo yêu cầu; fan-in khi kết quả của nhiều producer độc lập cần được gộp thành một luồng duy nhất; fan-out khi một luồng công việc đến cần được chia cho nhiều consumer đồng thời; pipeline khi công việc phân rã tự nhiên thành các stage biến đổi tuần tự; worker pool khi bạn có nhiều job đồng nhất và muốn một số lượng goroutine cố định để xử lý chúng; queuing khi cần buffer công việc và tách rời tốc độ của một producer nhanh khỏi một consumer chậm hơn, với backpressure kích hoạt ngay khi buffer đầy; và semaphore khi cần giới hạn số goroutine được phép vào một vùng code cùng lúc, bất kể bản thân công việc được cấu trúc thế nào.
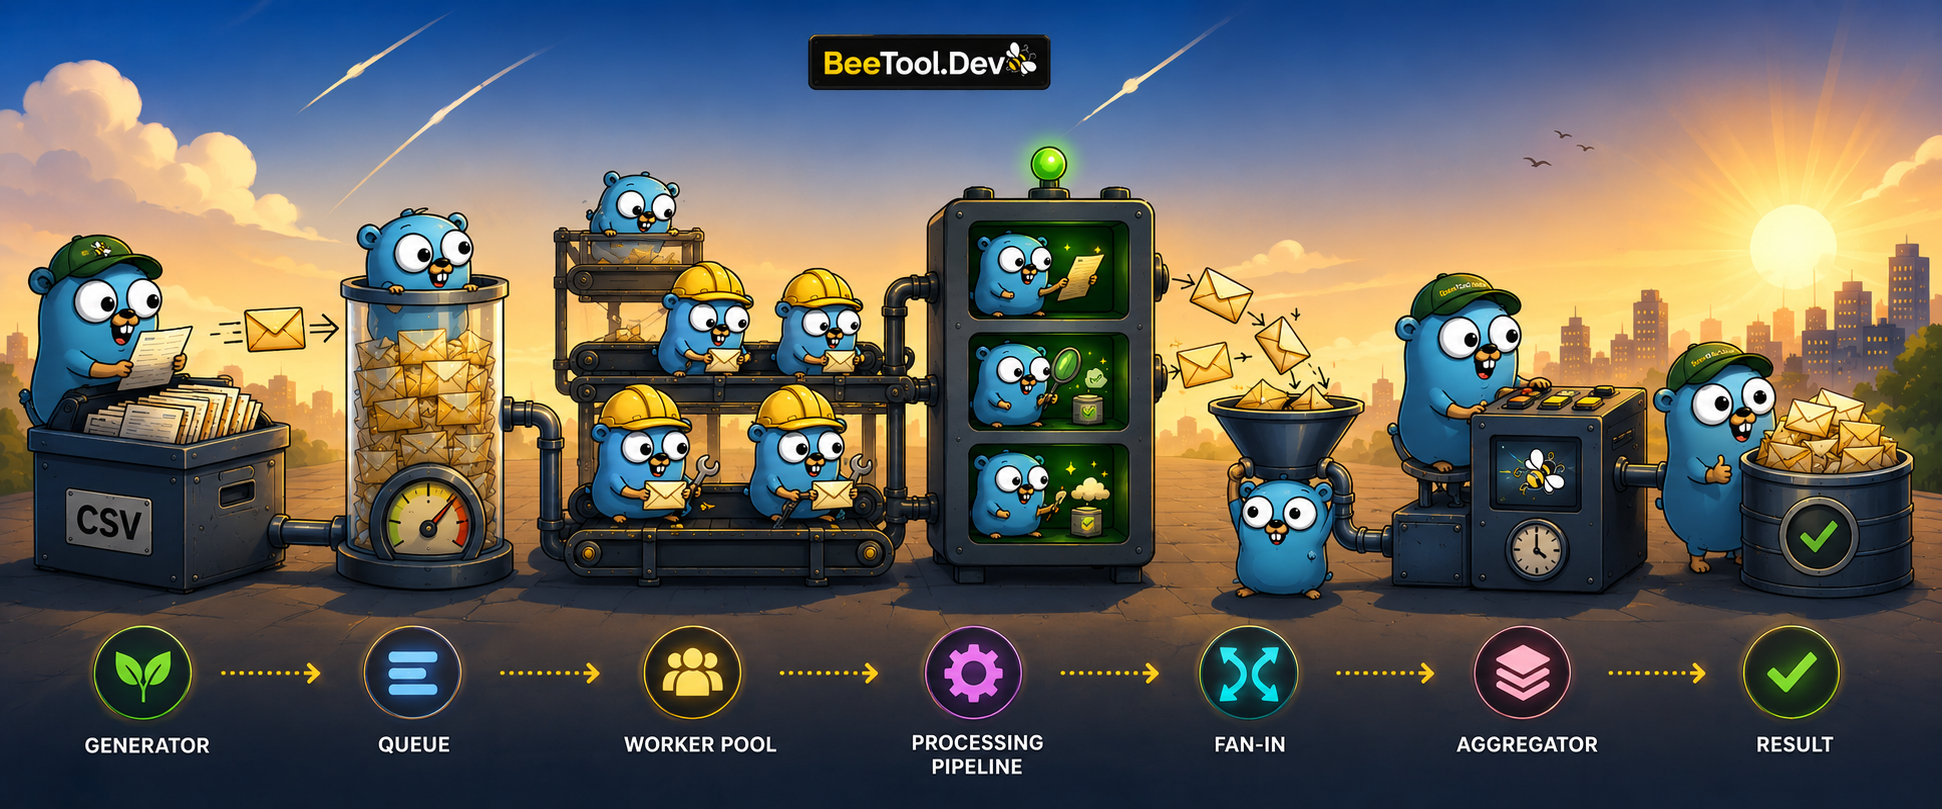
Trong hệ thống thực tế, các pattern này hiếm khi đứng một mình — chúng thường được nối chuỗi với nhau, channel đầu ra của pattern này trở thành channel đầu vào của pattern tiếp theo:
Generator → Queue → Fan-out / Worker Pool → Processing Pipeline → Fan-in / Aggregator → ResultHãy đọc chuỗi này như một câu chuyện, với một nhiệm vụ cụ thể: import 1 triệu đơn hàng từ file CSV vào database trước giờ mở bán sáng mai.
Câu chuyện bắt đầu ở Generator — một goroutine mở file CSV và đọc từng dòng, phát từng đơn hàng thô vào channel. Nó không đọc cả 1 triệu dòng vào bộ nhớ; nó chỉ đọc nhanh đúng bằng tốc độ mà phía sau kịp tiêu thụ. Ngay sau nó là Queue — một buffered channel 1.000 phần tử đóng vai người hãm nhịp: khi đĩa đọc nhanh hơn database ghi, buffer đầy dần và generator tự động bị chậm lại (backpressure), thay vì nhồi chết các tầng phía sau; trật tự đến-trước-xử-lý-trước vẫn được giữ nguyên. Từ queue, Worker Pool gồm 20 worker rút từng đơn hàng ra và chia tải — 20 đơn được xử lý đồng thời, không hơn, vì database chỉ chịu được chừng đó connection. Mỗi đơn hàng trong tay worker chảy qua Pipeline: parse dòng CSV thành struct → validate mã sản phẩm và số tiền → enrich thêm thông tin khách từ cache. Xử lý xong, kết quả từ 20 worker được Fan-in gom về một channel duy nhất, và đứng cuối là Aggregator — một batcher gom đủ 500 đơn (hoặc chờ tối đa 500ms) rồi thực hiện một lệnh batch insert duy nhất vào database, thay vì 1 triệu lệnh INSERT lẻ tẻ. Sáng hôm sau: 1 triệu đơn nằm gọn trong database, bộ nhớ chương trình chưa bao giờ vượt quá vài nghìn đơn đang bay.
Go triển khai mọi mắt xích trong chuỗi đó bằng cùng một bộ công cụ nhỏ: goroutine, channel, context, sync.WaitGroup và errgroup.
Generator

Generator là một hàm trả về một channel và tạo ra một chuỗi giá trị theo yêu cầu, tương tự yield trong JavaScript hay Python. Nó hoạt động được nhờ việc gửi và nhận trên channel đều block cho đến khi cả hai phía sẵn sàng: goroutine bên trong generator sẽ đứng chờ tại ch <- i cho đến khi có ai đó đọc từ ch.
func main() {
	ch := generator()

	for i := 0; i < 5; i++ {
		value := <-ch
		fmt.Println("Value:", value)
	}
}

func generator() <-chan int {
	ch := make(chan int)

	go func() {
		for i := 0; ; i++ {
			ch <- i
		}
	}()

	return ch
}
$ go run main.go
Value: 0
Value: 1
Value: 2
Value: 3
Value: 4
Hàm main chỉ lấy đúng năm giá trị từ channel rồi dừng đọc. Chú ý kiểu trả về <-chan int — mũi tên đứng trước chan biến đây thành channel chỉ-nhận (receive-only) từ góc nhìn của caller, một cách tự-tài-liệu-hóa khá hay: người gọi generator() có thể đọc từ nó nhưng không thể vô tình gửi hay đóng nó.
⚠️ Rò rỉ goroutine (goroutine leak): như đã viết, generator này làm rò rỉ goroutine sinh dữ liệu của nó. Vòng lặp
for i := 0; ; i++chạy mãi mãi, và một khimainngừng gọi<-chsau giá trị thứ năm, goroutine sẽ block vĩnh viễn tạich <- ivì không còn ai nhận nữa. Nó không bao giờ được garbage collector dọn — chỉ đứng đó, chờ mãi, trong suốt vòng đời chương trình. Trong mộtmainngắn hạn thì điều này vô hại, nhưng bên trong một service chạy dài hạn liên tục tạo generator, mỗi cái sẽ trở thành một rò rỉ vĩnh viễn. Cách khắc phục là cho goroutine một cách để biết khi nào cần dừng, thường là mộtdonechannel hoặccontext.Context, và dùngselectgiữa việc gửi giá trị và việc bị báo dừng. Xem "Hủy (cancellation) bằng done channel và context" trong phần bên dưới để xem phiên bản đã sửa.
Use case: iterator cho API phân trang
Cùng một khuôn mẫu đó mở rộng sang một nguồn dữ liệu thực tế: một HTTP API trả kết quả theo trang (pagination). Generator lấy một trang mỗi lần và chỉ gọi lại API khi caller đã tiêu thụ hết mọi thứ từ trang trước — consumer quyết định nhịp độ, và API không bao giờ bị hỏi nhiều hơn mức thực sự cần.
func fetchPages(ctx context.Context, url string) <-chan Item {
	out := make(chan Item)

	go func() {
		defer close(out)

		for page := 1; ; page++ {
			items, hasMore, err := fetchPage(ctx, url, page)
			if err != nil {
				return
			}
			for _, item := range items {
				select {
				case out <- item:
				case <-ctx.Done():
					return
				}
			}
			if !hasMore {
				return
			}
		}
	}()

	return out
}
Caller chỉ cần range qua kết quả: for item := range fetchPages(ctx, url) { ... }, hoàn toàn không cần biết đến việc phân trang. select cùng ctx.Done() chính là thứ giữ cho phiên bản này an toàn khỏi rò rỉ goroutine đã nói ở trên — nếu caller ngừng range sớm, việc hủy ctx sẽ mở khóa lệnh gửi và cho phép goroutine trả về.
Thêm use case
- Đọc từng record từ một database cursor
- Đọc từng dòng của một file CSV lớn mà không cần nạp toàn bộ vào bộ nhớ
- Phân trang qua một API và phát ra từng item ngay khi nó đến
- Sinh danh sách URL để một crawler ghé thăm
- Chuyển một luồng message Kafka thành một channel Go nội bộ
- Produce job để đưa vào một worker pool
Công cụ phù hợp
Đa số generator không cần thư viện nào cả — một goroutine, một channel và một context.Context đã đủ cho phần lớn trường hợp. Với nhu cầu xử lý stream nặng hơn, github.com/reugn/go-streams cung cấp một framework xử lý stream theo stage, còn github.com/ReactiveX/RxGo/v2 mang tới Observable với các toán tử Map/Filter/FlatMap. Dù dùng cách nào, hãy nhớ lời nhắc đã nêu ở phần trên: generator luôn nên nhận một context.Context — nếu consumer downstream ngừng đọc, goroutine gửi sẽ rò rỉ trừ khi nó có tín hiệu hủy để select cùng.
Code review: nhận biết và tránh lạm dụng
Nhận biết: một hàm trả về <-chan T với một goroutine bên trong gửi giá trị trong vòng lặp và (hy vọng là) có defer close.
Checklist khi review:
- Hàm có nhận
context.Contextvàselecttrênctx.Done()khi gửi không? - Ai đóng channel?
- Điều gì xảy ra nếu consumer ngừng range sớm — có đường rò rỉ nào không?
Tránh lạm dụng: với dữ liệu nhỏ, hữu hạn, đã có sẵn trong bộ nhớ, chỉ cần trả về []T — dựng cả một goroutine và channel để lặp qua slice 10 phần tử chỉ tổ tốn overhead và rủi ro rò rỉ mà chẳng được gì. Từ Go 1.23, iter.Seq đã bao phủ nhu cầu lazy iteration mà không cần goroutine nào cả.
// no channel needed
func evens(nums []int) []int {
	var out []int
	for _, n := range nums {
		if n%2 == 0 {
			out = append(out, n)
		}
	}
	return out
}
Fan-in
 Fan-in nhận nhiều channel đầu vào và ghép chúng (multiplex) thành một channel đầu ra duy nhất. Đây là pattern bạn dùng khi nhiều producer độc lập cần gộp kết quả của chúng thành một luồng để một consumer duy nhất xử lý. Vì các goroutine bên dưới đua nhau gửi, thứ tự các giá trị xuất hiện trong channel đầu ra không được đảm bảo — đừng phụ thuộc vào nó.
func main() {
	i1 := generateWork([]int{0, 2, 6, 8})
	i2 := generateWork([]int{1, 3, 5, 7})

	out := fanIn(i1, i2)

	for value := range out {
		fmt.Println("Value:", value)
	}
}

func fanIn(inputs ...<-chan int) <-chan int {
	var wg sync.WaitGroup
	out := make(chan int)

	wg.Add(len(inputs))

	for _, in := range inputs {
		go func(ch <-chan int) {
			for {
				value, ok := <-ch

				if !ok {
					wg.Done()
					break
				}

				out <- value
			}
		}(in)
	}

	go func() {
		wg.Wait()
		close(out)
	}()

	return out
}

func generateWork(work []int) <-chan int {
	ch := make(chan int)

	go func() {
		defer close(ch)

		for _, w := range work {
			ch <- w
		}
	}()

	return ch
}
Đọc từng bước: generateWork khởi chạy một goroutine cho mỗi slice đầu vào, gửi từng phần tử rồi đóng channel của nó bằng defer close(ch) khi xong việc — channel đã đóng đó chính là tín hiệu mà fan-in dựa vào. Bên trong fanIn, một goroutine được khởi chạy cho mỗi channel đầu vào; mỗi goroutine rút cạn channel của nó trong một vòng lặp, chuyển tiếp từng giá trị sang channel out dùng chung, và gọi wg.Done() ngay khi channel nguồn báo ok == false (nghĩa là đã đóng và đã rút cạn). Một goroutine riêng biệt chờ trên WaitGroup và chỉ đóng out khi tất cả các goroutine đầu vào đã hoàn tất — đó chính là điều giúp vòng lặp for value := range out trong main kết thúc gọn gàng thay vì block mãi mãi.
❌ Nguy cơ deadlock nếu quên đóng
out: toàn bộ lý dofanInkhởi chạy thêm goroutine "chờ rồi đóng" đó là đểoutđược đóng tự động. Nếu bạn bỏ goroutine đó đi và không bao giờ đóngout, vòng lặprange outtrongmainsẽ block mãi mãi sau khi nhận giá trị cuối cùng — chương trình treo mà không panic, không lỗi, không có gì để grep trong log. Bất cứ khi nào viết fan-in (hay fan-out, hay một stage trong pipeline), hãy tự hỏi rõ ràng: "ai đóng channel đầu ra này, và trong điều kiện nào?" Nếu câu trả lời là "không ai cả", bạn đang có một deadlock chờ sẵn để xảy ra.
Use case: truy vấn nhiều replica
Một tình huống production thường gặp: cùng một truy vấn tìm kiếm cần được gửi tới nhiều backend replica cùng lúc, và bạn muốn phản ứng với kết quả ngay khi chúng về thay vì chờ replica chậm nhất. Fan-in phản hồi của mỗi replica vào một channel dùng chung rồi tiêu thụ khi chúng tới.
func queryReplicas(ctx context.Context, query string, replicas []string) <-chan Result {
	var wg sync.WaitGroup
	out := make(chan Result, len(replicas)) // buffered so late replies never block

	for _, addr := range replicas {
		wg.Add(1)
		go func(addr string) {
			defer wg.Done()
			if res, err := search(ctx, addr, query); err == nil {
				out <- res
			}
		}(addr)
	}

	go func() {
		wg.Wait()
		close(out)
	}()

	return out
}
Một caller chỉ quan tâm câu trả lời nhanh nhất có thể lấy đúng giá trị đầu tiên — first := <-queryReplicas(ctx, q, replicas) — và để phần còn lại nằm chưa đọc trong buffer; một caller muốn câu trả lời của mọi replica thì chỉ cần range qua channel giống ví dụ fan-in cơ bản.
Thêm use case
- Gộp kết quả từ nhiều API backend thành một response
- Thu thập output của các worker xử lý file
- Merge nhiều luồng consumer Kafka thành một
- Gộp kết quả tìm kiếm lấy từ nhiều nguồn
- Thu thập metrics hoặc log do nhiều goroutine phát ra
- Kết hợp kết quả theo từng partition thành một kết quả cuối
Công cụ phù hợp
Đa số fan-in chỉ cần một channel cộng với một sync.WaitGroup, đúng như ví dụ ở trên. Khi cần lan truyền lỗi — nếu một producer nào đó lỗi thì toàn bộ thao tác nên coi là lỗi — errgroup.WithContext thường phù hợp hơn WaitGroup trần, vì nó cho bạn cả điểm join lẫn khả năng hủy trong cùng một package. Cũng đáng nhớ fan-in như người bạn đồng hành thường thấy của fan-out: hai pattern này gộp lại chính là "scatter-gather", được nói tới sau trong bài.
Code review: nhận biết và tránh lạm dụng
Nhận biết: nhiều tham số <-chan được gộp vào một channel out duy nhất, một sync.WaitGroup, và một goroutine riêng "chờ rồi close(out)".
Checklist khi review:
- Ai đóng
out, và trong điều kiện nào? - Mọi channel đầu vào có chắc chắn được đóng không — nếu không, các goroutine gộp sẽ rò rỉ vĩnh viễn?
- Có đoạn code nào downstream phụ thuộc vào thứ tự không? Fan-in phá vỡ thứ tự.
Tránh lạm dụng: với một số lượng kết quả nhỏ, cố định cần thu thập, dùng errgroup ghi vào các biến kết quả riêng biệt (hoặc một slice bảo vệ bằng mutex) đơn giản hơn và giữ được kiểu dữ liệu cụ thể — đừng dựng hẳn một cơ chế gộp channel chỉ để lấy 3 giá trị đã biết trước.
Fan-out
 Fan-out là ngược lại với fan-in: thay vì gộp nhiều đầu vào thành một, nó tách một channel đầu vào ra nhiều channel đầu ra để nhiều consumer có thể kéo việc về xử lý đồng thời. Điều này khác một cách tinh tế so với hệ thống publish/subscribe kinh điển — trong pub/sub, mỗi subscriber nhận được một bản sao của mỗi message, còn trong fan-out mỗi giá trị chỉ được gửi tới đúng một trong các channel đầu ra, bất kể consumer nào sẵn sàng trước. Đó chính là điều khiến fan-out hữu ích cho việc phân phối công việc thay vì broadcast sự kiện.
func main() {
	work := []int{1, 2, 3, 4, 5, 6, 7, 8}
	in := generateWork(work)

	out1 := fanOut(in)
	out2 := fanOut(in)
	out3 := fanOut(in)
	out4 := fanOut(in)

	for range work {
		select {
		case value := <-out1:
			fmt.Println("Output 1 got:", value)
		case value := <-out2:
			fmt.Println("Output 2 got:", value)
		case value := <-out3:
			fmt.Println("Output 3 got:", value)
		case value := <-out4:
			fmt.Println("Output 4 got:", value)
		}
	}
}

func fanOut(in <-chan int) <-chan int {
	out := make(chan int)

	go func() {
		defer close(out)

		for data := range in {
			out <- data
		}
	}()

	return out
}
Mỗi lần gọi fanOut(in) khởi chạy goroutine riêng của nó đọc từ cùng một channel in dùng chung và chuyển tiếp bất cứ gì đọc được sang channel out riêng của nó. Vì cả bốn goroutine đều cạnh tranh nhau để nhận từ in, Go runtime sẽ tự nhiên phân tải tám phần việc trên out1 đến out4. Trong main, câu lệnh select chính là thứ khiến fan-out này hữu ích: nó block cho đến khi bất kỳ channel đầu ra nào trong bốn channel có giá trị sẵn sàng, nên main không bao giờ ưu ái một channel đầu ra hơn các channel khác và không bao giờ lãng phí thời gian poll một channel rỗng.
Use case: worker tạo thumbnail
Một job fan-out kinh điển: một channel chứa đường dẫn ảnh vừa upload cần được resize thành thumbnail, và bạn muốn một số lượng worker cố định cùng lấy việc từ channel đó thay vì một goroutine cho mỗi ảnh upload.
func resizeWorkers(paths <-chan string, n int) {
	var wg sync.WaitGroup
	wg.Add(n)

	for i := 0; i < n; i++ {
		go func(id int) {
			defer wg.Done()

			for path := range paths {
				if err := resizeThumbnail(path); err != nil {
					log.Printf("worker %d: %s: %v", id, path, err)
				}
			}
		}(i)
	}

	wg.Wait()
}
Cả n worker đều đọc từ cùng một channel paths, nên worker nào rảnh trước sẽ lấy ảnh tiếp theo — chính cơ chế cân bằng tải bằng cạnh tranh đã làm ví dụ fanOut ở trên hoạt động, chỉ gộp lại thành một hàm duy nhất thay vì gọi fanOut riêng cho mỗi consumer.
Thêm use case
- Resize ảnh song song
- Gửi email hoặc push notification
- Crawl một danh sách URL
- Validate record từ một batch upload
- Gọi nhiều API bên ngoài
- Parse log hoặc payload JSON
- Xử lý message Kafka song song
- Hash, nén hoặc mã hóa file
Fan-out phù hợp nhất khi các item cần xử lý phần lớn độc lập với nhau — việc xử lý item này không phụ thuộc vào kết quả của item khác.
Công cụ phù hợp
Khối xây dựng vẫn là channel và goroutine như trên, nhưng một vài thư viện giúp bạn khỏi phải viết lại cùng một đoạn boilerplate: errgroup để lan truyền lỗi kèm hủy; x/sync/semaphore để giới hạn concurrency; sourcegraph/conc cho một API structured-concurrency; github.com/alitto/pond/v2 cho một worker pool có giới hạn; và panjf2000/ants/v2 cho một goroutine pool dung lượng cố định, tái sử dụng được.
Code review: nhận biết và tránh lạm dụng
Nhận biết: nhiều goroutine cùng range trên cùng một channel đầu vào.
Checklist khi review:
- Số lượng consumer có bị giới hạn không, và con số đó có được biện minh bởi điều gì thực tế không?
- Có gì downstream giả định về thứ tự không? Fan-out phá vỡ thứ tự.
- Các item có thực sự độc lập với nhau — không có shared mutable state nào thiếu khóa?
Tránh lạm dụng: khi công việc trên mỗi item quá nhỏ (vài micro giây), chi phí chuyển giao qua channel còn tốn hơn chính công việc đó — một vòng lặp tuần tự đơn giản sẽ thắng. Với công việc CPU-bound, nhiều worker hơn runtime.NumCPU() chỉ làm tăng chi phí scheduling mà không tăng throughput.
Pipeline
 Pipeline nối một chuỗi các stage lại với nhau bằng channel, trong đó mỗi stage nhận giá trị từ channel upstream, biến đổi nó theo cách nào đó, rồi gửi kết quả xuống downstream. Stage đầu tiên — stage không có đầu vào upstream — được gọi là source hay producer; stage cuối cùng, chỉ tiêu thụ mà không gửi tiếp, là sink hay consumer. Lợi ích lớn nhất của việc cấu trúc code theo cách này là mỗi stage có thể được sửa đổi, kiểm thử, hoặc thay thế độc lập, và các stage trở thành những khối lắp ghép có thể sắp xếp lại hoặc tái sử dụng giữa các pipeline khác nhau.
func main() {
	in := generateWork([]int{0, 1, 2, 3, 4, 5, 6, 7, 8})

	out := filter(in) // Filter odd numbers
	out = square(out) // Square the input
	out = half(out)   // Half the input

	for value := range out {
		fmt.Println(value)
	}
}

func filter(in <-chan int) <-chan int {
	out := make(chan int)

	go func() {
		defer close(out)

		for i := range in {
			if i%2 == 0 {
				out <- i
			}
		}
	}()

	return out
}

func square(in <-chan int) <-chan int {
	out := make(chan int)

	go func() {
		defer close(out)

		for i := range in {
			value := math.Pow(float64(i), 2)
			out <- int(value)
		}
	}()

	return out
}

func half(in <-chan int) <-chan int {
	out := make(chan int)

	go func() {
		defer close(out)

		for i := range in {
			value := i / 2
			out <- value
		}
	}()

	return out
}
$ go run main.go
0
2
8
18
32
Lần theo các con số qua pipeline sẽ giải thích được output này: filter chỉ giữ lại các số chẵn (0, 2, 4, 6, 8), square nâng mỗi số đó lên lũy thừa hai (0, 4, 16, 36, 64), và half chia đôi mỗi giá trị đã bình phương (0, 2, 8, 18, 32). Mọi stage đều theo đúng một khuôn mẫu giống hệt nhau — cấp phát channel đầu ra, khởi chạy goroutine range qua đầu vào của nó và defer close đầu ra khi đầu vào đã cạn, rồi trả về channel đầu ra ngay lập tức mà không block. Vì mỗi stage close channel đầu ra của chính nó ngay khi xong việc, tín hiệu đóng sẽ lan truyền tự nhiên xuống pipeline: khi source đóng, filter hoàn tất việc range và đóng đầu ra của nó, việc đó cho phép square hoàn tất và đóng, cứ thế tiếp tục, cho đến khi đầu ra của half đóng và vòng lặp range out trong main kết thúc gọn gàng.
Use case: pipeline xử lý log
Cùng một khuôn mẫu đó lắp ráp thành một job xử lý log thực tế: đọc các dòng thô, parse mỗi dòng thành JSON, chỉ giữ lại các entry mức lỗi, rồi ghi chúng ra. Mỗi stage giữ đúng kiểu chữ ký hàm của filter/square/half ở trên — chỉ phần nối dây trong main là cần thay đổi.
func readLines(path string) <-chan string                       { /* ... */ }
func parseJSON(in <-chan string) <-chan LogEntry                { /* ... */ }
func filterErrors(in <-chan LogEntry) <-chan LogEntry           { /* ... */ }
func writeSink(in <-chan LogEntry, w io.Writer) <-chan struct{} { /* ... */ }

func main() {
	lines := readLines("access.log")
	entries := parseJSON(lines)
	errors := filterErrors(entries)
	done := writeSink(errors, os.Stdout)

	<-done // block until writeSink has drained everything and closed done
}
writeSink là stage sink: nó không có gì downstream để gửi tiếp, nên thay vì trả về một channel giá trị, nó trả về một <-chan struct{} sẽ đóng khi mọi entry đã được ghi xong — một biến thể nhỏ của pattern giúp main có thứ để block chờ.
Thêm use case
Các stage của pipeline đọc rất tự nhiên như những chuỗi mũi tên — một vài ví dụ tiêu biểu:
Data import:      Read CSV → Parse row → Validate → Transform → Batch insert DB
Image processing: Read → Decode → Resize → Compress → Upload S3
Event processing: Consume Kafka → Deserialize → Validate → Enrich → Business logic → Publish
Log processing:   Read → Parse → Filter → Aggregate → Export
Công cụ phù hợp
Mặc định vẫn là một channel, một goroutine và một context.Context cho mỗi stage, đúng như đã xây ở trên. Với pipeline phức tạp hơn — có nhánh rẽ, chính sách buffer, hay windowing — hãy dùng go-streams hoặc RxGo, hoặc, một khi pipeline trải rộng hơn một process, Watermill, thư viện xây pipeline ở mức message/event trên các broker như Kafka, RabbitMQ, hoặc Pub/Sub của PostgreSQL. Quy tắc ngón tay cái: pipeline dựa trên channel phù hợp với công việc nằm gọn trong một process; một khi pipeline cần trải rộng qua nhiều service, đó là việc dành cho Watermill hoặc một broker.
Code review: nhận biết và tránh lạm dụng
Nhận biết: một chuỗi hàm có dạng func(<-chan T) <-chan U, mỗi hàm khởi chạy một goroutine với defer close(out), được nối lại trong main kiểu out = square(filter(in)).
Checklist khi review:
- Mọi stage có đóng channel đầu ra của nó không?
- ctx/done có được luồn qua MỌI stage không — một stage không thể dừng sẽ làm rò rỉ cả chuỗi?
- Stage nào là nút thắt cổ chai? Cả chuỗi chạy theo tốc độ của stage chậm nhất.
Tránh lạm dụng: đây là trường hợp lạm dụng kinh điển — với một phép biến đổi đơn giản trên một slice đã có sẵn trong bộ nhớ, một vòng lặp thường ngắn hơn, nhanh hơn, không cấp phát thêm bộ nhớ, và dễ debug hơn nhiều:
// A 3-stage channel pipeline to do this is complexity theater:
var evens []int
for _, n := range nums {
	if n%2 == 0 {
		evens = append(evens, n*n/2)
	}
}
Pipeline chỉ thực sự đáng giá với dữ liệu dạng streaming, tập dữ liệu quá lớn để nạp hết vào bộ nhớ, hoặc các stage có đặc tính IO/CPU thực sự khác nhau.
Worker Pool
 Worker pool tách rời số lượng goroutine đang làm việc khỏi số lượng công việc cần làm, bằng cách cố định một tập nhỏ các worker goroutine sống lâu dài, tất cả cùng lấy việc từ một channel jobs dùng chung. Cách này tránh được pattern "một goroutine cho mỗi job", vốn có thể sinh ra số lượng goroutine không giới hạn khi số job lớn hoặc khó dự đoán.
const totalJobs = 4
const totalWorkers = 2

func main() {
	jobs := make(chan int, totalJobs)
	results := make(chan int, totalJobs)

	for w := 1; w <= totalWorkers; w++ {
		go worker(w, jobs, results)
	}

	for j := 1; j <= totalJobs; j++ {
		jobs <- j
	}

	close(jobs)

	for a := 1; a <= totalJobs; a++ {
		<-results
	}

	close(results)
}

func worker(id int, jobs <-chan int, results chan<- int) {
	var wg sync.WaitGroup

	for j := range jobs {
		wg.Add(1)

		go func(job int) {
			defer wg.Done()

			fmt.Printf("Worker %d started job %d\n", id, job)

			result := job * 2
			results <- result

			fmt.Printf("Worker %d finished job %d\n", id, job)
		}(j)
	}

	wg.Wait()
}
Ở đây, totalWorkers goroutine được khởi chạy sẵn ngay từ đầu, và mỗi job — một số int từ 1 đến totalJobs — được đẩy vào channel jobs có buffer. Việc đóng jobs sau khi mọi job đã được gửi chính là điều cho phép vòng lặp for j := range jobs của mỗi worker kết thúc khi channel đã cạn, thay vì block mãi mãi chờ thêm job. Cả jobs lẫn results đều có buffer với dung lượng bằng totalJobs, nên việc gửi vào chúng không block phía gửi để chờ phía nhận sẵn sàng. Làm điểm khởi đầu cho việc tính kích thước, totalWorkers thường nên gần với runtime.NumCPU() — xem "Chọn kích thước worker pool" trong phần Các mối quan tâm xuyên suốt bên dưới để hiểu sự khác biệt giữa công việc CPU-bound và IO-bound.
Use case: gửi 10.000 webhook
Fan-out HTTP có giới hạn là một trong những cách dùng phổ biến nhất của worker pool: 10.000 URL webhook mỗi cái cần một request POST, nhưng mở 10.000 kết nối đồng thời sẽ dội tải lên cả hai phía. Năm mươi worker lấy việc từ một channel jobs chứa URL giữ cho concurrency có giới hạn mà vẫn hoàn thành nhanh.
const totalWorkers = 50

func sendWebhooks(urls []string) []Result {
	jobs := make(chan string, len(urls))
	results := make(chan Result, len(urls))

	for w := 0; w < totalWorkers; w++ {
		go func() {
			for url := range jobs {
				status, err := postWebhook(url)
				results <- Result{URL: url, Status: status, Err: err}
			}
		}()
	}

	for _, url := range urls {
		jobs <- url
	}
	close(jobs)

	out := make([]Result, 0, len(urls))
	for range urls {
		out = append(out, <-results)
	}
	return out
}
Đây chính xác là cùng một khuôn mẫu với ví dụ worker/jobs/results ở trên, chỉ thay totalJobs bằng len(urls) và tăng totalWorkers từ 2 lên 50 — pattern không đổi, chỉ có con số thay đổi.
Thêm use case
- Giới hạn số request gửi tới một API bên thứ ba
- Giới hạn số truy vấn database chạy đồng thời
- Xử lý file upload: resize, chuyển mã, tạo thumbnail
- Gửi email hàng loạt
- Xử lý message từ một topic Kafka hoặc RabbitMQ
- Chạy một job migrate dữ liệu hàng loạt
- Crawl web
- Công việc nặng CPU như nén hoặc hash
- Chạy background job bên trong một service sống lâu dài
Điểm mấu chốt đáng khắc cốt ghi tâm: worker pool không thực sự là để "chạy nhanh hơn" — mà là về giới hạn tài nguyên. Bạn có thể có 10.000 job cần xử lý, nhưng phía downstream chỉ đủ sức chịu 20 HTTP request đồng thời, 10 truy vấn database đồng thời, hay 4 lần encode ảnh đồng thời. Pool tồn tại để bảo vệ bất cứ thứ gì đứng ở đầu kia của công việc, chứ không phải để tối đa hóa throughput của chính bạn.
Công cụ phù hợp
Thư viện | Phù hợp nhất khi |
|---|---|
| Một tập task hữu hạn, đã biết trước — chờ tất cả, hủy mọi thứ khi có lỗi đầu tiên |
| Chỉ cần giới hạn concurrency, không cần gì thêm |
| Một worker pool có giới hạn dùng cho mục đích tổng quát |
| Khối lượng task cực lớn — tái sử dụng goroutine thay vì tạo mới liên tục |
| Bạn muốn một API structured-concurrency |
| Một pool đơn giản có sẵn hàng đợi job nội bộ |
Code review: nhận biết và tránh lạm dụng
Nhận biết: một vòng lặp for w := 1; w <= N khởi chạy các worker giống hệt nhau, đọc từ một channel jobs và ghi vào một channel results.
Checklist khi review:
- Tài nguyên thực tế nào biện minh cho con số N — số connection DB, giới hạn của API, hay số nhân CPU?
- Channel jobs có được đóng để worker kết thúc được không?
- Kết quả có được rút cạn hoàn toàn không? Results có buffer mà không được rút cạn nghĩa là worker bị kẹt hoặc mất dữ liệu.
- Lỗi thoát ra khỏi pool bằng cách nào?
Tránh lạm dụng: với một tập task nhỏ, hữu hạn, errgroup cùng SetLimit chỉ tốn năm dòng và tự lo cả lỗi lẫn hủy — đừng tự tay dựng một pool cho 5 task, và đừng với tới các thư viện pool trước khi tình trạng sinh/hủy goroutine thực sự trở thành vấn đề đã được đo đạc.
Queuing
Queuing nghĩa là channel mang chính công việc: job là dữ liệu thực (payload), và nó chảy qua channel từ một producer goroutine sang một consumer goroutine. Nhiệm vụ của channel ở đây là buffer, giữ thứ tự gần đúng FIFO, và tách rời tốc độ producer đẩy việc vào khỏi tốc độ consumer rút việc ra — khi buffer đầy, lệnh gửi sẽ block và producer cảm nhận được backpressure thay vì để queue phình to vô hạn. Trong code, đây là một chan Job (hoặc chan Item, chan Task — bất cứ gì mang payload thực): lệnh gửi xảy ra ở một goroutine, lệnh nhận xảy ra ở một goroutine khác.
Một job queue trong bộ nhớ đơn giản trông như thế này: một HTTP handler đẩy việc vào queue, và một pool worker rút việc ra rồi xử lý.
type Job struct {
	OrderID string
	Payload []byte
}

var jobs = make(chan Job, 1000) // 1000 job có thể chờ trước khi một lệnh gửi bị block

func handleUpload(w http.ResponseWriter, r *http.Request) {
	job := Job{OrderID: r.FormValue("order_id"), Payload: readBody(r)}

	select {
	case jobs <- job: // enqueue
		w.WriteHeader(http.StatusAccepted)
	case <-r.Context().Done():
		http.Error(w, "client gone", http.StatusRequestTimeout)
	}
}

func startWorkers(n int) {
	for i := 0; i < n; i++ {
		go func() {
			for job := range jobs { // dequeue
				process(job)
			}
		}()
	}
}
handleUpload là producer và các goroutine do startWorkers khởi chạy là consumer; buffered channel giữa chúng đang làm đúng công việc của queuing. Nó làm mượt các đợt burst — tối đa 1.000 lượt upload có thể chất đống trong một đợt tăng traffic mà không có gì bị block — và giữ nguyên thứ tự các job đến. Khi buffer đầy, jobs <- job sẽ block: đó chính là backpressure, queue đẩy ngược lại phía producer thay vì phình to vô giới hạn.
Ví dụ "queuing" kinh điển hay xuất hiện trong nhiều tutorial — một chan struct{} mà một số lượng goroutine cố định tranh nhau — thực chất là một semaphore đội lốt queuing. Dấu hiệu tố cáo nằm ngay trong kiểu dữ liệu: không có dữ liệu nào chảy qua một chan struct{} cả, nên thực ra chẳng có gì được xếp hàng (queue), chỉ có việc throttle. Xem phần Semaphore ngay bên dưới để thấy đúng ví dụ đó, được làm cho đàng hoàng.
Queue trong bộ nhớ vs queue bền vững
Buffered channel jobs := make(chan Job, 1000) dùng xuyên suốt bài này là một queue trong bộ nhớ (in-memory): producer và consumer sống trong cùng một process, job sẽ mất nếu process crash hoặc restart, và nó cho bạn buffering đơn giản cộng backpressure miễn phí. Một luồng điển hình: một HTTP handler đẩy vào một buffered channel, và một pool worker rút cạn nó — buffered channel ở đây làm nhiệm vụ kép, vừa là queue vừa là semaphore.
Đó là lựa chọn đúng cho đến khi một trong những điều sau trở thành sự thật, lúc đó bạn cần một queue bền vững hoặc phân tán thay thế:
- Job phải sống sót qua việc restart hoặc crash của process
- Producer và consumer là hai service khác nhau
- Bạn cần retry hoặc task trì hoãn/lên lịch
- Bạn muốn scale consumer theo chiều ngang, qua nhiều instance
- Bạn cần xử lý dead-letter cho các job liên tục thất bại
- Bạn cần một lịch sử sự kiện có thể replay lại
Công cụ | Phù hợp với |
|---|---|
Asynq | Task nền, trì hoãn, và lên lịch dựa trên Redis |
RabbitMQ | Command/task queue, routing, retry, request/reply |
Kafka | Event stream, audit log, kiến trúc event-driven, replay |
Watermill | Một lớp trừu tượng message-handler/middleware/Pub-Sub trên nhiều broker |
| Kafka client thuần Go |
| Client cho RabbitMQ/AMQP |
Code review: nhận biết và tránh lạm dụng
Nhận biết: một channel mang kiểu payload thực (chan Job, chan Task, ...) băng qua ranh giới goroutine — được gửi từ một goroutine, nhận ở một goroutine khác, thường có buffer.
Checklist khi review:
- Kích thước buffer có được biện minh bởi điều gì thực tế không? Điều gì thực sự xảy ra khi buffer đầy — producer bị block, hay có gì đó âm thầm drop job?
- Nếu process crash, việc mất những gì còn đang nằm trong channel có chấp nhận được không? Nếu không, đây cần là một queue bền vững, không phải queue trong bộ nhớ.
- Ai đóng channel, và mọi vòng lặp
rangecủa consumer có thực sự thấy nó đóng rồi thoát ra không?
Tránh lạm dụng: đừng dùng một buffered channel khổng lồ như một cách thay thế rẻ tiền cho queue bền vững — mọi thứ trong đó biến mất ngay khi process biến mất. Và đừng chèn một queue giữa hai stage vốn luôn chạy cùng tốc độ; buffer bằng 0 (hoặc nhỏ) là ổn khi không có chênh lệch tốc độ thực sự cần làm mượt — một buffer quá khổ chỉ che giấu tín hiệu backpressure chứ chẳng giải quyết được gì.
Semaphore
 Semaphore là một công cụ khác hẳn, dù Go thường dựng nó từ đúng loại channel mà queuing dùng. Trong khi queuing đẩy dữ liệu thực qua một channel, channel của semaphore mang token, không phải dữ liệu — không có gì mang ý nghĩa chảy qua nó cả. Semaphore đứng bên ngoài một vùng code, giống như một cánh cổng với một số lượng chìa khóa cố định: lấy được một token cho phép goroutine bước vào vùng được canh gác, còn release trả lại chìa khóa cho ai đang chờ tiếp theo. Acquire và release xảy ra trong cùng một goroutine, bao quanh bất kỳ đoạn code nào cần giới hạn — đó chính là khác biệt về cấu trúc so với queuing, nơi lệnh gửi nằm ở một goroutine (producer) còn lệnh nhận nằm ở một goroutine khác (consumer).
Semaphore với đúng một permit là binary semaphore, hành xử gần như mutex, với một khác biệt thú vị: mutex nên được unlock bởi chính bên đã lock, còn permit của semaphore có thể được release hợp lệ bởi một goroutine khác với goroutine đã acquire nó.
Đây là ví dụ "queuing" từ nhiều tutorial, làm cho đàng hoàng — nó là một semaphore, nên channel được đặt tên sem và chứa token, không phải job:
const limit = 2
const work = 10

func main() {
	var wg sync.WaitGroup

	fmt.Println("Semaphore limit:", limit)
	sem := make(chan struct{}, limit)

	wg.Add(work)

	for w := 1; w <= work; w++ {
		process(w, sem, &wg)
	}

	wg.Wait()

	close(sem)
	fmt.Println("Work complete")
}

func process(work int, sem chan struct{}, wg *sync.WaitGroup) {
	sem <- struct{}{} // acquire

	go func() {
		defer wg.Done()

		time.Sleep(1 * time.Second)
		fmt.Println("Processed:", work)

		<-sem // release
	}()
}
Có 10 đơn vị công việc nhưng chỉ có 2 permit trong sem. Mỗi lần gọi process trước tiên thực hiện sem <- struct{}{} — đây là acquire — và nếu sem đã chứa đủ limit token, lệnh gửi này sẽ block cho đến khi có permit trống, đây chính là hành vi throttle mà chúng ta muốn. Khi đã chiếm được một permit, công việc thực sự chạy trong goroutine riêng của nó và, khi hoàn tất, thực hiện <-sem — đây là release — để trả permit lại cho ai đang chờ tiếp theo. Chú ý rằng cả acquire lẫn release đều xảy ra quanh cùng một đơn vị công việc, trong cùng một luồng goroutine: không có Job hay payload nào từng được đọc ra khỏi sem cả, chỉ có một token rỗng mang nghĩa "có một chỗ trống". Kết quả là tối đa hai đơn vị công việc chạy đồng thời tại bất kỳ thời điểm nào, dù cả mười đơn vị đều được nộp vào ngay lập tức.
Trong Go, semaphore nhẹ ký idiomatic chính là buffered channel chứa empty struct đó — đáng xem ở dạng chuẩn tắc của nó, với acquire và release được ghép cặp qua defer để release luôn xảy ra trên mọi đường thoát:
sem := make(chan struct{}, 3) // a semaphore with 3 permits

func doWork(id int) {
	sem <- struct{}{}        // Acquire — blocks while 3 goroutines hold permits
	defer func() { <-sem }() // Release — always paired via defer

	// ... at most 3 goroutines ever run this section at once ...
}
Khi cần nhiều hơn một bộ đếm đơn thuần, câu trả lời chuẩn của hệ sinh thái là golang.org/x/sync/semaphore — một weighted semaphore. Hai điều khiến nó đáng để import: Acquire nhận context.Context, nên goroutine đang kẹt chờ permit có thể bỏ cuộc khi request bị hủy hoặc timeout; và permit mang trọng số (weight), nên một task nặng có thể chiếm nhiều slot cùng lúc:
import "golang.org/x/sync/semaphore"

var sem = semaphore.NewWeighted(100) // e.g. "100 MB of in-flight work"

func handle(ctx context.Context, sizeMB int64) error {
	if err := sem.Acquire(ctx, sizeMB); err != nil {
		return err // ctx was cancelled or timed out while waiting
	}
	defer sem.Release(sizeMB)

	return process(sizeMB) // total in-flight weight never exceeds 100
}
Còn có TryAcquire — lấy permit mà không block, trả về false thay vì chờ — hữu ích cho hành vi "shed load thay vì xếp hàng".
Chọn giữa hai cách: channel semaphore thắng về độ đơn giản khi permit đồng nhất và không cần hủy; hãy dùng semaphore.Weighted khi bạn cần chờ có nhận biết context, permit có trọng số (ngân sách bộ nhớ, đơn vị chi phí), hoặc thử lấy không-block.
sem.Release(5) // ❌ panic: "semaphore: released more than held" if you only acquired 3

sem <- struct{}{}
work()          // ⚠️ if work() panics, the permit leaks — always release with defer
<-sem
Hai lỗi kinh điển: release nhiều hơn số đã acquire (weighted semaphore panic to và rõ), và quên release trên đường lỗi — mỗi permit rò rỉ làm co vĩnh viễn giới hạn hiệu dụng của bạn, cho đến khi mọi acquire block mãi mãi.
Use case: bảo vệ một API bị giới hạn tốc độ (rate-limited)
Một API bên thứ ba áp rate limit là use case semaphore kinh điển: giới hạn số lệnh gọi ra ngoài ở một mức concurrency cố định để không bao giờ chạm ngưỡng giới hạn, bất kể có bao nhiêu caller bên trong service của bạn muốn gọi cùng lúc.
var apiLimiter = semaphore.NewWeighted(10)

func callThirdPartyAPI(ctx context.Context, req Request) (Response, error) {
	if err := apiLimiter.Acquire(ctx, 1); err != nil {
		return Response{}, err // ctx was canceled while waiting for a slot
	}
	defer apiLimiter.Release(1)

	return httpClient.Do(ctx, req) // at most 10 calls in flight at once
}
Mọi caller của callThirdPartyAPI, ở bất cứ đâu trong service, đều dùng chung một apiLimiter — chính đặc tính "giới hạn concurrency bất kể công việc được cấu trúc thế nào" khiến semaphore khác với worker pool.
Code review: nhận biết và tránh lạm dụng
Nhận biết: make(chan struct{}, N) đi kèm cặp sem <- struct{}{} / <-sem bao quanh một vùng code, hoặc semaphore.NewWeighted.
Checklist khi review:
- Việc release có được đảm bảo trên MỌI đường đi, kể cả khi panic hay lỗi (dùng
defer) không? - Con số N có bắt nguồn từ một giới hạn thực tế, đã được ghi rõ không?
- Có trường hợp acquire-lồng-trong-acquire nào có thể tự deadlock không?
Tránh lạm dụng: nếu N sẽ là 1 và mục tiêu là truy cập độc quyền vào shared state, hãy dùng sync.Mutex thay vào đó — nó nói đúng điều nó làm, và go vet hiểu được nó. Nếu nhu cầu là "tối đa N việc đang chạy trong toàn bộ ứng dụng", hãy kiểm tra xem tài nguyên đó đã tự giới hạn sẵn chưa (ví dụ SetMaxOpenConns của database/sql) trước khi thêm một lớp giới hạn riêng của bạn.
Scatter-gather
Scatter-gather là fan-out và fan-in kết hợp lại thành một pattern có tên riêng: rải (scatter) một request ra nhiều service, rồi gom (gather) kết quả của chúng lại thành một response tổng hợp.
Request → Scatter to multiple services → Gather results → Combined responseUse case điển hình: một API gateway gọi song song tới các service user, order và payment để ghép thành một response; tìm kiếm đồng thời trên PostgreSQL, Elasticsearch và cache; định giá sản phẩm bằng cách hỏi nhiều nhà cung cấp; kiểm tra tồn kho trên nhiều kho hàng; lấy cùng một dữ liệu từ nhiều khu vực.
errgroup thường là cách viết sạch nhất cho việc này — đơn giản hơn nhiều so với tự viết tay các channel kết quả và một WaitGroup:
var user User
var orders []Order
var payments []Payment

g, ctx := errgroup.WithContext(ctx)

g.Go(func() error {
	var err error
	user, err = loadUser(ctx, userID)
	return err
})
g.Go(func() error {
	var err error
	orders, err = loadOrders(ctx, userID)
	return err
})
g.Go(func() error {
	var err error
	payments, err = loadPayments(ctx, userID)
	return err
})

if err := g.Wait(); err != nil {
	return nil, err
}
Code review: nhận biết và tránh lạm dụng
Nhận biết: một errgroup (hoặc WaitGroup) với nhiều lệnh gọi g.Go, mỗi lệnh ghi vào biến kết quả riêng của nó, theo sau bởi một lệnh Wait duy nhất.
Checklist khi review:
- Mỗi goroutine chỉ ghi vào biến của riêng nó chứ? Ghi vào biến dùng chung cần khóa.
- Chính sách khi lỗi một phần là gì — lỗi đầu tiên hủy tất cả (errgroup), hay mọi lỗi đều được thu thập?
- Có timeout riêng cho từng lệnh gọi qua context không?
Tránh lạm dụng: nếu lệnh gọi B cần kết quả của lệnh gọi A, chúng vốn dĩ tuần tự — scatter chúng ra là một lỗi, không phải một tối ưu. Và với hai lệnh gọi nhanh mà độ trễ không quan trọng, code tuần tự dễ đọc và dễ debug hơn scatter-gather.
Batching
Batching gộp nhiều item nhỏ lại với nhau trước khi xử lý chúng như một đơn vị:
item → item → item → [batch of 100] → database
Use case điển hình: batch insert vào PostgreSQL, gộp batch các lần gửi của một Kafka producer, bulk-index vào Elasticsearch, gộp batch telemetry hoặc metrics, gửi log hàng loạt, và gửi request API hàng loạt.
Quyết định cốt lõi trong một batcher là khi nào flush, và câu trả lời hầu như luôn là "cái nào đến trước": batch đạt tới giới hạn kích thước (chẳng hạn 100 item) hoặc một khoảng thời gian trôi qua (chẳng hạn 500ms) kể từ lần flush cuối — giới hạn thời gian tồn tại để những giai đoạn ít traffic không khiến item phải chờ vô thời hạn.
func batcher(in <-chan Item, flush func([]Item)) {
	const maxBatch = 100
	const maxWait = 500 * time.Millisecond

	batch := make([]Item, 0, maxBatch)
	ticker := time.NewTicker(maxWait)
	defer ticker.Stop()

	for {
		select {
		case item, ok := <-in:
			if !ok {
				if len(batch) > 0 {
					flush(batch)
				}
				return
			}
			batch = append(batch, item)
			if len(batch) >= maxBatch {
				flush(batch)
				batch = make([]Item, 0, maxBatch)
			}
		case <-ticker.C:
			if len(batch) > 0 {
				flush(batch)
				batch = make([]Item, 0, maxBatch)
			}
		}
	}
}
Công cụ: một channel cộng time.Ticker hoặc time.Timer đủ dùng cho phần lớn trường hợp, thường đi kèm một worker pool để xử lý song song từng batch đã flush. Nhiều thư viện client Kafka và driver database đã tự batch bên trong rồi, nên hãy kiểm tra trước khi tự xây thêm một lớp batching riêng.
Batching thường nằm ở cuối một pipeline, ngay trước tài nguyên chậm và tốn kém cho mỗi lần gọi: Generator → Validate workers → Fan-in → Batcher → Database.
Code review: nhận biết và tránh lạm dụng
Nhận biết: một goroutine giữ một slice buf, select giữa một channel item và một time.Ticker, flush khi đủ kích thước hoặc khi tick.
Checklist khi review:
- Có lệnh flush CUỐI CÙNG khi channel đầu vào đóng không? Thiếu bước này là lỗi kinh điển "mất phần đuôi".
- Buffer có được copy khi flush không, hay việc tái sử dụng cùng một mảng nền sẽ làm alias dữ liệu?
- Kích thước batch tối đa nhân với kích thước mỗi item có tạo ra một mức tiêu thụ bộ nhớ giới hạn, chấp nhận được không?
Tránh lạm dụng: driver database, Kafka producer, hay HTTP client của bạn thường đã tự batch sẵn rồi — batch hai lần chỉ làm tăng độ trễ mà chẳng được gì. Ghi với lưu lượng thấp (vài lần mỗi giây) thì không cần batcher chút nào.
Pub/Sub
Pub/Sub gửi một message tới mọi subscriber, không chỉ một:
OrderCreated event → Email service / Analytics service / Loyalty service
Sự tương phản với worker pool chính là điểm mấu chốt: trong worker pool, mỗi task được tiêu thụ bởi đúng một worker; trong pub/sub, mỗi subscriber nhận bản sao riêng của mỗi message.
Use case điển hình: publish domain event, invalidate cache, gửi notification, audit logging, nuôi analytics, giữ đồng bộ read model, và nói chung là các kiến trúc microservice event-driven.
Công cụ trải dài từ trong-process đến hoàn toàn phân tán: bên trong một process duy nhất, channel riêng cho mỗi subscriber hoặc một event bus nhỏ là đủ; Redis Pub/Sub cho bạn một cơ chế broadcast nhẹ nhưng nhất thời (không replay, không lưu trữ); Kafka cho bạn độ bền và khả năng replay; exchange của RabbitMQ cho bạn routing linh hoạt; và Watermill chuẩn hóa API publisher/subscriber/middleware trên bất kỳ lựa chọn nào trong số đó.
Code review: nhận biết và tránh lạm dụng
Nhận biết: một registry các channel subscriber cùng một vòng lặp publish gửi cùng một message tới từng channel.
Checklist khi review:
- Điều gì xảy ra khi một subscriber chậm — lệnh gửi không buffer trong vòng lặp có làm block TẤT CẢ subscriber khác không?
- Có đường unsubscribe không? Channel subscriber bị bỏ quên sẽ rò rỉ.
- Kỳ vọng về delivery — at-most-once hay at-least-once — có được ghi rõ không?
Tránh lạm dụng: với đúng một consumer, đó chỉ là một channel — đừng khoác cho nó cái tên pub/sub. Giữa hai component trong cùng process, gọi hàm trực tiếp rõ ràng hơn. Và đừng dựng một event bus trong-process khi yêu cầu thực sự là delivery bền vững (durable) — đó là việc của một broker.
Singleflight (gộp request)
Singleflight gộp nhiều request đồng thời giống hệt nhau thành một lần thực thi duy nhất, rồi chia sẻ kết quả đó cho mọi caller đã hỏi:
100 requests for user:123 → 1 database query → result shared with 100 callers
Use case điển hình: bảo vệ khỏi cache-stampede khi cache miss đồng thời, gộp các lệnh gọi refresh token, gộp việc load config, gộp việc lấy tỷ giá hối đoái — bất cứ khi nào một tài nguyên dùng chung tốn kém có thể bị dội bởi một loạt request đồng thời trùng lặp cho cùng một key.
golang.org/x/sync/singleflight là công cụ chuẩn cho việc này:
var g singleflight.Group

func getUser(ctx context.Context, id string) (User, error) {
	v, err, _ := g.Do(fmt.Sprintf("user:%s", id), func() (any, error) {
		return fetchUserFromDB(ctx, id)
	})
	if err != nil {
		return User{}, err
	}
	return v.(User), nil
}
Đây chính là thư viện đã được nhắc ngắn gọn trong phần thư viện bên dưới — xem phần đó để hiểu nó ánh xạ vào pattern fan-in như thế nào về mặt khái niệm.
Code review: nhận biết và tránh lạm dụng
Nhận biết: singleflight.Group với g.Do(key, fn).
Checklist khi review:
- Key có đủ chi tiết không? Key quá thô sẽ serialize hóa những công việc chẳng liên quan gì đến nhau.
- Caller có coi kết quả dùng chung là CHỈ-ĐỌC không? Mọi caller nhận cùng một con trỏ — sửa nó là một race.
- Lưu ý về hủy: context của caller đầu tiên sẽ chi phối toàn bộ lệnh gọi dùng chung cho mọi người.
Tránh lạm dụng: chỉ đáng dùng cho các lần đọc tốn kém, bị trùng lặp thường xuyên — bọc một truy vấn rẻ tiền chỉ thêm phức tạp mà chẳng được gì. Không bao giờ dùng cho các thao tác GHI: gộp 100 lệnh gọi "tạo đơn hàng" thành một lần thực thi làm thay đổi ngữ nghĩa, không chỉ hiệu năng.
Rate limiting
Rate limiting kiểm soát số task bắt đầu trong mỗi đơn vị thời gian — một trục khác hẳn worker pool, vốn giới hạn số task đang chạy đồng thời tại bất kỳ thời điểm nào:
Worker pool:    max 20 tasks running at once
Rate limiter:   max 100 task starts per second
Use case điển hình: tôn trọng giới hạn công bố của một API bên ngoài (chẳng hạn 100 request/giây); giữ dưới mức throughput cho phép của nhà cung cấp email; giới hạn số lần thử đăng nhập; throttle một job migrate nền để không làm quá tải database; bảo vệ bất kỳ service downstream nào khỏi một đợt burst.
golang.org/x/time/rate là công cụ chuẩn:
limiter := rate.NewLimiter(rate.Limit(100), 10) // 100 events/sec, burst of 10

func callAPI(ctx context.Context, req Request) (Response, error) {
	if err := limiter.Wait(ctx); err != nil {
		return Response{}, err // ctx canceled while waiting for a slot
	}
	return httpClient.Do(ctx, req)
}
Trong production hai thứ này thường được xếp chồng lên nhau, mỗi cái giải quyết một vấn đề khác nhau:
Queue → Rate limiter (100 req/s) → Worker pool (max 20 concurrent) → External API
Code review: nhận biết và tránh lạm dụng
Nhận biết: rate.NewLimiter với limiter.Wait(ctx) hoặc Allow() đứng trước một thao tác.
Checklist khi review:
- Limiter có được tạo MỘT LẦN và dùng chung không? Một limiter tạo mới cho mỗi request thì chẳng giới hạn được gì — một lỗi kinh điển.
- Burst có được cấu hình có chủ đích không, thay vì để mặc định không khớp với thực tế lưu lượng?
Waitcó nhận một ctx thực sự để việc shutdown không bị chặn vô thời hạn không?
Tránh lạm dụng: các lệnh gọi nội bộ không có hạn ngạch bên ngoài hiếm khi cần throttle. Và nếu vấn đề thực sự là "quá nhiều việc chạy cùng lúc", đó là một giới hạn concurrency — semaphore hoặc pool — chứ không phải một rate; nhầm lẫn hai thứ này là kiểu lạm dụng phổ biến nhất của pattern này.
Các pattern khác
Ngoài bảy pattern ở trên, có vài pattern liên quan đáng để biết tên dù bài này không đi sâu xây dựng: tee channel nhân đôi mỗi giá trị từ một channel đầu vào ra hai channel đầu ra riêng biệt, hữu ích khi hai stage độc lập đều cần thấy cùng một luồng dữ liệu; bridge channel làm phẳng một "channel của các channel" thành một channel duy nhất, tiện khi một chuỗi channel được sinh ra động theo thời gian; ring buffer channel bọc một buffer vòng kích thước cố định để producer có thể ghi đè lên phần tử cũ nhất chưa đọc thay vì block, đánh đổi mất dữ liệu để lấy việc ghi không-bao-giờ-block; và bounded parallelism là tên gọi chung cho kỹ thuật semaphore ở trên — giới hạn số goroutine đồng thời ở một con số N cố định bất kể tổng số task là bao nhiêu.
Các mối quan tâm xuyên suốt
Ba mục dưới đây không phải là những khối pattern độc lập như generator hay pipeline — chúng là những mối quan tâm áp dụng xuyên suốt bất kể bạn chọn pattern nào, và mọi pattern trong bài này rốt cuộc đều cần đến chúng khi lên production.
Hủy (cancellation) bằng done channel và context
Pattern generator ở đầu bài làm rò rỉ goroutine vì nó không có cách nào biết được bên nhận đã ngừng lắng nghe. Cách khắc phục là cho goroutine thêm một thứ để select, hoặc là một done channel riêng, hoặc là một context.Context, để nó có thể thoát ra thay vì block mãi mãi:
func generator(done <-chan struct{}) <-chan int {
	ch := make(chan int)

	go func() {
		defer close(ch)

		for i := 0; ; i++ {
			select {
			case ch <- i:
				// value delivered, keep going
			case <-done:
				return // caller gave up, stop producing
			}
		}
	}()

	return ch
}

func main() {
	done := make(chan struct{})
	defer close(done)

	ch := generator(done)

	for i := 0; i < 5; i++ {
		fmt.Println("Value:", <-ch)
	}
	// closing done unblocks the goroutine's next select, and it returns
}
select bên trong vòng lặp đua hai trường hợp: hoặc giá trị được gửi thành công trên ch, hoặc done đã đóng, lúc đó goroutine trả về ngay lập tức và close(ch) đã defer sẽ chạy. Đúng khuôn mẫu này — luồn một done channel hoặc ctx.Done() xuyên suốt mọi stage của fan-out, fan-in, hay pipeline, và select trên nó ở bất cứ đâu bạn vốn dĩ sẽ block trên một lệnh gửi channel — là cách chuẩn để biến bất kỳ pattern nào trong bài này thành có thể hủy được. Khi source của một pipeline bị hủy theo cách này, việc đóng channel đầu ra của nó sẽ lan truyền việc dừng qua mọi stage downstream tự động, giống hệt cách hoàn tất bình thường vẫn hoạt động.
Chọn kích thước worker pool
Không có một con số worker "đúng" duy nhất — nó phụ thuộc vào việc công việc là CPU-bound hay IO-bound. Với công việc CPU-bound (tính toán nặng, không block trên network/disk), nhiều worker hơn runtime.NumCPU() chỉ làm tăng chi phí scheduling mà không tăng throughput, vì các nhân CPU đã bão hòa; runtime.NumCPU() là một giá trị mặc định hợp lý. Với công việc IO-bound (gọi HTTP, truy vấn database, I/O file), worker dành phần lớn thời gian bị block chờ một thứ gì đó bên ngoài thay vì dùng CPU, nên việc chạy nhiều worker hơn hẳn số nhân CPU — đôi khi lên tới hàng trăm — là chuyện bình thường và thường cần thiết để tăng throughput, vì chúng phần lớn ở trạng thái idle dưới góc nhìn của scheduler.
Với các trường hợp đơn giản kiểu "chạy N việc đồng thời rồi chờ", cũng đáng để biết đến golang.org/x/sync/errgroup, package bọc một sync.WaitGroup với khả năng lan truyền lỗi và (qua SetLimit) giới hạn concurrency có sẵn, thường thay thế được đoạn code worker-pool viết tay chỉ bằng vài dòng:
g, ctx := errgroup.WithContext(ctx)
g.SetLimit(runtime.NumCPU())

for _, job := range jobs {
	job := job
	g.Go(func() error {
		return process(ctx, job)
	})
}

if err := g.Wait(); err != nil {
	// first error from any goroutine, others are canceled via ctx
}
Backpressure
Một channel không có buffer (unbuffered) giữa hai stage của pipeline sẽ tự nhiên throttle bên chạy nhanh hơn: stage producer block trên lệnh gửi cho đến khi stage consumer sẵn sàng nhận, nên một producer nhanh không bao giờ có thể chạy vượt xa một consumer chậm và chất đống bộ nhớ không giới hạn. Đây là backpressure "miễn phí", chỉ đến từ ngữ nghĩa của channel. Thêm buffer vào (như các ví dụ worker pool và queuing đã làm) sẽ nới lỏng việc throttle đó — producer có thể chạy trước một số lượng phần tử cố định trước khi bị block — đây là một sự đánh đổi có chủ đích giữa việc làm mượt các đợt burst và việc từ bỏ cơ chế throttle tự động. Khi bộ nhớ hoặc tải downstream là mối lo, hãy ưu tiên buffer nhỏ hoặc không buffer; khi mục tiêu là làm mượt các producer có tính bùng nổ, hãy chọn kích thước buffer một cách có chủ đích thay vì để nó lớn tùy tiện.
Các thư viện nổi tiếng triển khai những pattern này
Trong code production bạn hiếm khi phải tự tay viết lại các pattern này — hệ sinh thái đã có sẵn những bản triển khai được tôi luyện, và đọc cách chúng ánh xạ vào những gì ta vừa xây là cách tốt nhất để thấm pattern.
golang.org/x/sync/errgroup — worker pool + fan-out kèm xử lý lỗi. Chuẩn de-facto cho bài toán "chạy N task đồng thời, chờ tất cả, và fail cùng nhau". SetLimit biến nó thành worker pool có giới hạn — chính là pattern semaphore của chúng ta — chỉ trong một dòng, còn errgroup.WithContext cho bạn sẵn hệ thống hủy mà ta đã tự nối dây bằng done channel:
g, ctx := errgroup.WithContext(ctx)
g.SetLimit(4) // bounded parallelism — pattern semaphore, có sẵn

for _, url := range urls {
	g.Go(func() error {
		return fetch(ctx, url) // lỗi đầu tiên sẽ cancel ctx cho tất cả các task còn lại
	})
}

if err := g.Wait(); err != nil { // điểm join
	log.Fatal(err)
}
golang.org/x/sync/semaphore — pattern semaphore, tổng quát hóa. Một weighted semaphore: Acquire(ctx, n) / Release(n) làm đúng việc mà sem <- struct{}{} / <-sem của ta đã làm, nhưng có hủy theo context và cho phép một task nặng chiếm nhiều hơn một slot.
golang.org/x/sync/singleflight — gộp các request đồng thời giống hệt nhau thành một. Xem phần Singleflight riêng ở trên để có ví dụ đầy đủ; đây chính là thư viện đứng sau cơ chế chống thundering-herd của groupcache.
Chính thư viện chuẩn. Server của net/http là pattern fan-out ở quy mô hành tinh: mỗi connection một goroutine, sinh ra từ vòng lặp accept. database/sql giấu một semaphore bên trong: SetMaxOpenConns là một semaphore giới hạn số connection đồng thời, và bên gọi bị block y hệt hàm process của chúng ta. Và từ Go 1.23, package iter (iter.Seq, range-over-func) chính là pattern generator được chính thức hóa vào ngôn ngữ — một generator không còn rủi ro rò rỉ goroutine, vì việc lặp giờ chỉ là một lệnh gọi hàm.
Pool bên thứ ba. sourcegraph/conc gói các pattern này trong một API structured-concurrency (conc.WaitGroup, pool.Pool với .WithMaxGoroutines(), kèm sẵn propagation cho panic); panjf2000/ants là một goroutine pool hiệu năng cao tái sử dụng goroutine để cắt chi phí lập lịch và stack khi bạn bắn hàng triệu task nhỏ.
Lời khuyên thực dụng: mặc định dùng
errgroupcho mọi thứ có dạng "N task, chờ tất cả, lan truyền lỗi" — nó do Go team bảo trì và đọc lên y như pattern trong sách. Chỉ tự viết channel khi luồng dữ liệu thật sự đặc thù (pipeline, streaming), và chỉ với tớiconc/antskhi profiling cho thấy chính việc sinh/hủy goroutine là nút thắt cổ chai.
Chọn một pattern
Các pattern ở trên không phải bài tập học thuật — mỗi pattern ánh xạ vào những bài toán bạn sẽ gặp trong công việc backend thường ngày. Dùng bảng dưới đây để đi từ nhu cầu bạn có tới pattern phù hợp; các ví dụ use case đan xen trong từng phần ở trên minh họa chi tiết hơn cho từng dòng.
Nhu cầu | Pattern |
|---|---|
Sinh ra một luồng dữ liệu | Generator |
Chia item cho nhiều goroutine | Fan-out |
Gom kết quả từ nhiều goroutine | Fan-in |
Chia việc xử lý thành nhiều stage | Pipeline |
Giới hạn số task chạy đồng thời | Worker pool / semaphore |
Giữ task tạm thời trong process | Queuing |
Task phải sống sót qua restart | Distributed queue |
Một event tới nhiều service | Pub/Sub |
Gọi nhiều service, gộp kết quả | Scatter-gather |
Gộp record trước khi insert | Batching |
Nhiều request đồng thời giống hệt nhau | Singleflight |
Giới hạn throughput theo thời gian | Rate limiting |
Hai quy tắc chọn nhanh: nếu các đơn vị công việc đồng nhất và bạn chủ yếu cần giới hạn concurrency, hãy dùng worker pool hoặc semaphore. Nếu công việc phân rã tự nhiên thành các stage với tốc độ khác nhau, hãy dùng pipeline và để backpressure của channel tự cân bằng các stage.
Bình luận